ai修图评测怎么写才可信?一个评测编辑的自白
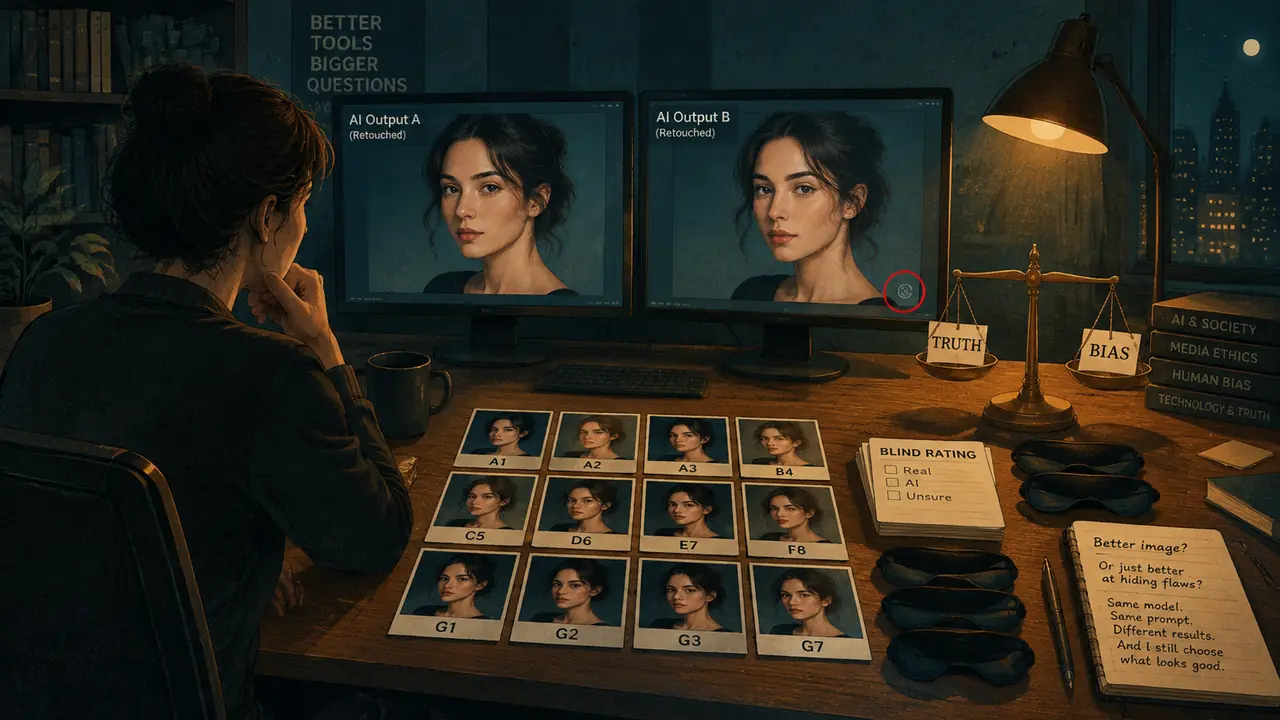
可信难写:评测的可信度不靠文笔,靠流程——同一批测试图、同一套导出参数、必要时的盲评,加上敢把翻车写进原文的底气。送测号里通着会员,是最容易漏算的变量。打开下一篇评测前,先扫一眼它有没有版本号、有没有缺点、有没有更新标注。
ai修图评测最难的不是测出效果,而是让读者信你测出来的效果。工具好不好是技术问题,读者信不信你是信任问题。写了六年修图工具评测,被厂商公关约过饭,也被读者在评论区骂过恰饭,我的结论只有一句:可信不是喊出来的,是靠样本、流程和认错的勇气一点点攒出来的。
一批测试图跑到底,比任何话术都管用
样本公平靠三件事撑着:同一批图、同一套流程、必要时的盲评。缺一件,结论再漂亮也站不住。这三件事没有一件花哨,但每件都能筛掉大半水分。
我的固定图集是36张,2023年年初攒起,之后只换不删:逆光人像12张、夜景8张、猫狗毛发特写6张、远处招牌和铁丝网10张。每类图各有用途——测磨皮用逆光油皮人像,测锐化用猫的胡须,测去摩尔纹用那种拍出来全是波纹的展厅屏幕。图集公开在文末附件里,文件名带拍摄参数,读者下载下来自己跑一遍,输出跟我的截图一比,结论真假一验便知。
流程也要写死。同一版本号(比如「v3.2.1,2026年8月14日的包」)、同一导出参数(JPEG质量90、保留EXIF)、磨皮滑块一律先跑默认值再跑50%,两档都截图。缺了这些,你写「效果出色」,读者根本无法复现,等于白说。
盲评更狠。2025年3月那期横评,我把7款工具的输出全部乱序重命名成a1到g7,丢给没参与测试的同事挑,他连哪张是谁家的都不知道。结果第一名和我们内部预期的差了两个位次。评测不做盲评,就像美食评委站在灶台边看厨师做菜再打分——嘴下多少会留情。话说回来,盲评也救了我自己:有次我把主观看好的那款排第一,盲评结果出来,我只能认。
送测号里的会员,是最容易漏算的变量
送测账号大多通着高级会员,读者手里的免费版没有这些能力。拿会员功能写结论,等于替读者买一张他不会买的票。这个变量不写清楚,全文都可疑。
2025年11月我测一款「超清人像修复」,厂商给的送测号每月120张AI积分,随便跑。好奇心驱使,我拿自己手机号重新注册了个免费号,跑到第2张就弹窗:「今日免费额度已用完,开通会员解锁批量修复」——会员档一年328元。同一款工具,两个账号,体验完全是两个产品。
更隐蔽的是功能分层。去水印、4K导出、批量处理,常常锁在会员档里,而评测文章里最出效果的那几张图,恰恰是这些功能跑出来的。读者读完心潮澎湃,注册免费版一用,处处碰壁。坑就挖在这一步。
所以我现在守三条规矩:送测号只用来摸功能边界;正式出图全部用免费注册的号重跑一遍;结论里必须写明「免费版能做到哪一步、卡在哪」。饭局可以去,饭钱争取自己付,稿子发布前不给对方预审——有人觉得矫情,可稿子一旦让厂商先看过,读者的「恰饭」指控你就永远洗不清了。说实话,被骂不可怕,可怕的是心里那杆秤歪了,自己还没察觉。
2024年10月,我漏掉的那个水印
读者最不信三类评测:只有优点、截图全是官方样张、没有一条翻车记录。翻车记录恰恰是可信度的证据。我自己就被这条规矩教训过。
先说那三类。通篇找不到一句缺点的,读者默认你收了钱;截图全是官方样张、连一张自己拍的图都没有的,读者默认你根本没用过;从头到尾没有翻车记录、好像从没失手的,读者默认你测得太浅。三类的共同点是一样的——看不到「失败」这个变量。
2024年10月,我写一款一键出图工具的评测,夸了它的构图重组,效果确实惊艳。漏了一件事:免费版导出的图右下角带工具logo水印,而我那批样图里有3张是会员号导出的——会员档没有水印。发布当晚,评论区一个ID贴出对比图:「编辑用的是会员号吧?免费用户导出直接糊个logo在角上。」那条评论两小时被顶到最前,点赞比我原文的收藏还多。那晚我盯着屏幕,脸上发烫。
第三天我补了声明:用全新注册的免费号把36张测试图全部重跑,把水印的位置、大小写进原文——导出1280x720的图,右下角水印约占180x40像素,遮挡范围肉眼可见。改动的地方逐条列出,原文不删,顶部加「2024年10月21日更新」标注。删文重发永远比补测声明省事,但删文等于告诉读者:这个作者会抹掉对自己不利的记录。
这次翻车也让我想明白修图评测跟手机评测的区别。手机是硬件,参数焊死在机身里,跑分摆在那,重测可以用同一台机器;修图工具是跑在别人云端上的算法,大版本三个月一换,模型更新连公告都懒得发,你上周测的这周可能就变了,旧版本一下架就永远回不去。所以修图评测更依赖两样东西:文内必须写版本号和测试日期,结论失效时必须回原文标注更新。读者收藏的不是一篇文章,是某个时间点的一份结论——这就是评测的更新义务,躲不掉。
回到开头那句话:可信是攒出来的。36张固定测试图、一套写进文章的流程、一次敢留在原文里的翻车,比十句「客观公正」都值钱。下次点开一篇评测,先扫它有没有版本号、有没有缺点、有没有更新标注——三眼看完,信不信,你心里自然有数。
常见问题
评测用的测试图集可以公开吗?
可以,而且公开更好。我的图集带文件名、拍摄参数和用途说明,读者拿同一批图自己跑一遍,输出跟文内截图一比对,结论是否成立当场见分晓。公开图集还有个副作用:厂商没法说你「测试图选得太刁钻」,因为任何人都可以验证这批图是不是刻意针对谁。
厂商公关看到不利结论会来施压吗?
会,但多数时候不是威胁,是商量。常见的诉求有两种:希望你补一句「正式版会优化」,或者希望评测推迟两周发、等新版本上线。我的处理原则是结论不改,补测可以——新版本真修复了就更新标注,没修复就照发。约饭可以,预审稿子不行,这条从2021年入行第一年就立住了,六年没破过例。
怎么判断一篇旧评测的信息还新不新鲜?
看三处:文内有没有写测试的具体版本号和日期;页面顶部有没有「更新于」的标注;评论区有没有读者指出问题后作者的回应记录。三处都空着,就按半年前的旧闻处理,别拿它做今天的付费决定。修图工具的结论保质期普遍不超过一个大版本周期,大约三个月。