gpt image 2.5 翻车实录:首日十张图的失败清单
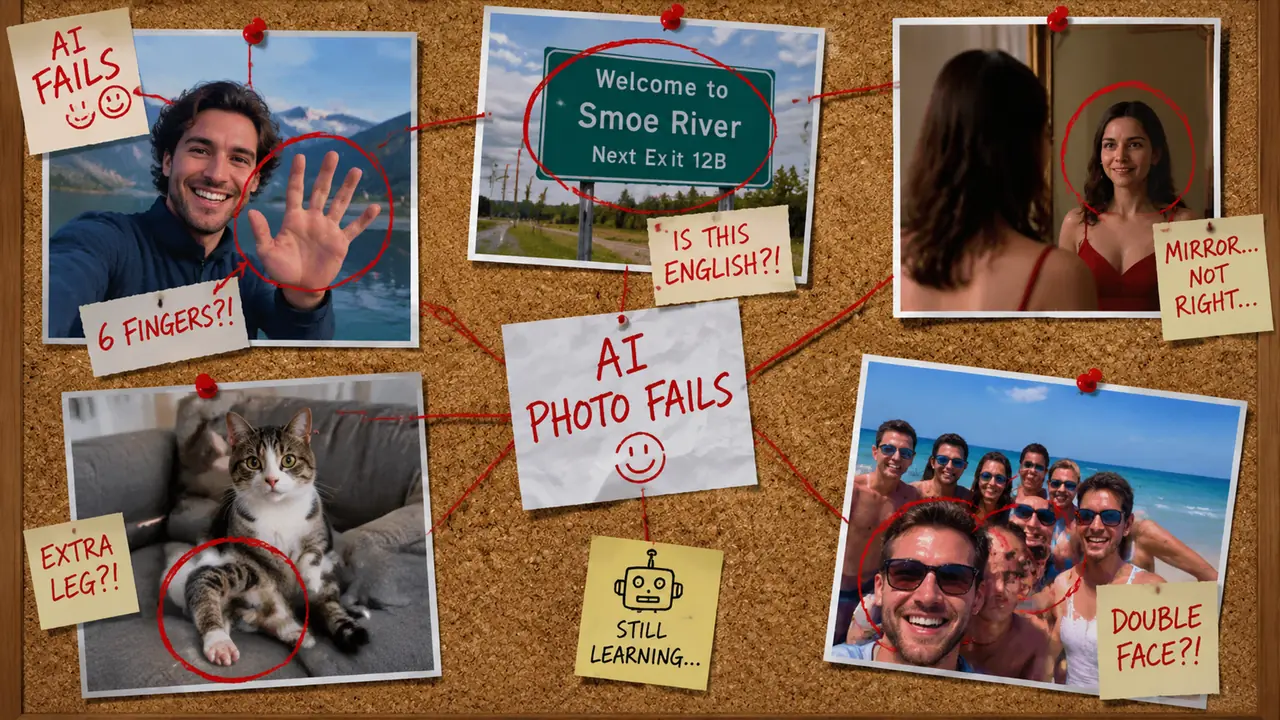
先摆结论:翻车不挑图,挑指令。越是要它"想一下"的地方,摔得越狠;一句话能说死的改动,基本不会出事。
gpt image 2.5 翻车这事,我是发布当天下午就撞上的。那天我一口气喂了十张图,有旧照片、街拍、商品图,还有两张带镜子的室内照。改到最后我做了一份失败清单:十张里真正一次过的只有三张,剩下七张分别在五个地方栽了跟头——手指、文字、镜子反射、半截执行、改A动B。这份清单就是这篇的全部内容,每种姿势配当时的具体场景,和我后来摸索出的绕开办法。
手指:老毛病没断根,只是换了花样
单手特写稳,多手交叠必翻,指令里把手指动作写死是唯一有效的办法。这是十张图里我验证最彻底的一条。
具体场景是这样的:一张咖啡店约会照,两个人碰杯,画面里一共四只手。第一遍出来,女生左手五个手指是齐的,右手四根,杯柄穿过了虎口。男生那边更离谱,握杯的手指和杯耳长在了一起。我重试三次,四只手从来没同时正常过,最好的一次是三对一残。
单手托咖啡杯的特写倒是没出问题,五根手指清清楚楚。我琢磨下来的规律是:它画一只手靠的是"平均印象",两只手一旦有接触、交叠、传递东西,就要现场推理谁的手指压着谁,这一步就是摔的地方。绕开办法有两个,要么改构图让画面里只出现一只手,要么指令写成"左手四指可见,拇指按杯壁,右手不入画"——把每根手指的岗位派好,成功率肉眼可见地上去了。
文字:让它"改两个字",它给你重写一整块
带文字的图,只要指令里没写"其余文字保持原样",它就默认有权重新创作。这张图我返工了五次。
那张图是一张促销海报,我只想把"满300减30"改成"满200减20"。指令发过去,改是改了,海报下面一行小字"活动最终解释权归门店所有"变成了另一句文绉绉的话,左上角的品牌名英文还拼错了一个字母。第二遍我补了一句"其他文字不动",小字保住了,品牌名照错。
第五遍我才摸到门道:把不许动的文字逐字写进指令,"顶部品牌名保持XXX三个字母不变,底部小字保持原文,只替换中间价格数字"。它确实认字,改出来的"满200减20"笔画干净利落,这点比老版本强多了。毛病出在它太热衷表现自己会写字——你给它留了任何发挥空间,它就要添一笔。所以带文字的图,指令要么全圈死,要么干脆把文字区域裁出来单独改。
镜子:反射内容是它的推理考卷,交白卷那种
镜子和玻璃反射里的内容,它基本是"编"的,不是"算"的,人拿东西的画面重灾区。这两张室内照翻得最冤。
第一张是卧室自拍,人对着穿衣镜。原图里我朋友举着手机拍照,我让它把背景杂物清一下。出来之后地面干净了,镜子里却多了一扇原图里没有的窗。第二张更典型:玄关镜,原图里镜子里该映出沙发一角,改完之后沙发还在,镜子里换成了一幅画。
说白了,反射内容要求模型在脑子里做一次空间推理——光源在哪、视角在哪、镜面里该出现什么。这恰好是它最弱的环节。它知道"镜子里应该有个房间",就随手布置一个合理的房间,不去对照画面本身。我的绕开办法分两步:能裁掉镜子就裁掉,构图上避开;裁不掉,就把指令写成"镜面反射内容与原图完全一致,不得增删任何物体"。这么写之后,玄关那张第四遍才对,卧室那张到最后也没完全对,镜子里的窗变成了一盏灯。能用通用的图就别留着镜子较劲。
复杂指令只执行一半,改A动B:两兄弟是一个病根
一次下三四个要求,它通常只老老实实做两个;你指哪它改哪,但它会顺手改你不指的地方。这两类翻车我合并讲,因为病根一样。
半截执行的例子:商品图我让它"换成木桌面背景、加上下午茶氛围、杯口加一点热气"。出来一看,背景换了,热气也有,"下午茶氛围"没了——没有点心,没有桌面上的小物件,就是块光秃秃的木板。它执行了字面最具体的两项,把需要自己发挥想象的那项直接丢了。
改A动B的例子更气人:街拍里我只说"把左边红色邮筒改成绿色",改完邮筒是绿了,行人外套的蓝也深了一个色号,整张图的色温跟着变了。它不是没听懂,是把"改颜色"理解成了"调整这张图的色彩"。
绕开的思路我总结成三句话:一次只派一个任务,做完验收再派下一个;形容词换成名词,"下午茶氛围"写不成"桌上放两块司康饼和一壶茶";被改动范围写死边界,"仅邮筒本体变色,画面其余元素包括色温保持原样"。按这个来,那天下午的后四张图,我的重试次数从平均五次降到了两次左右。
这套"一次一个任务"的纪律,其实跟我之前做批量API修图时是一样的,指令模板写得越死,跑得越稳,感兴趣的可以看那篇ai修图程序怎么搭?用API批量修图的自建尝试。
回看这十张图,翻车点可以分成两类:靠记忆复现的都过了,靠现场推理的几乎全挂。这不是玄学,是它的干活方式决定的。手指、文字这类,训练数据里见过海量的样本,它是在"背",所以规整场景背得很准。镜子反射、复杂指令拆解、改动范围控制,这些要求它对着眼前这张从未见过的图现场做空间和逻辑推演,推不动就编一个看着合理的答案交差。所以同样是翻车,姿势不同,解法相通:把推理替它做完,你自己先想清楚每根手指、每行字、每面镜子该是什么样,写成一条条名词化的短指令塞给它。它当画笔很好用,你让它兼当策划,它就开始自由发挥。
同一天我也拿几张没翻的图整理过前后对比,怎么看对比图里的门道,可以翻翻这篇ai修图图片怎么看门道?读前后对比图的六个细节。
十张图跑完,我对这台新机器的态度是:能力确实上了一个台阶,中文文字、整体质感都比印象里的旧版强不少,可它的失败清单也没变过位置——哪里要推理,哪里就埋雷。发布首日这份失败清单我留着了,下回上手先看图里有没有镜子、有没有交叠的手、有没有要动的文字,有的话,指令提前写死。工具没变,变的是你得替它把脑子带上。
常见问题
翻车的图还有救吗,还是直接放弃重出?
看翻在哪。文字拼错、颜色不对这类局部问题,补一条范围锁死的短指令再改一两轮,多数能救回来。手指交叠、镜子内容错乱这类结构问题,救的成本高,我一般直接改构图重出,比反复重试省额度。
重试几次没效果就该停手吗?
我给自己定的线是三次。同一处毛病重试三次还犯,说明指令本身没解决根因,这时候该改指令而不是继续抽卡。把模糊的形容词换成具体的名词和数字,往往第二遍就过了。
指令写得越详细越好吗?
详细不等于长。有效的是具体:数字、位置、颜色名、逐字的文案。无效的是堆要求,一段指令里塞四个任务,它必丢一两个。详细指每句话说死一个点,不是写小作文。
这些翻车坑在新版本里会修好吗?
文字渲染这块从我的体感看确实比旧版进步明显,中文基本不乱码了。反射和空间推理属于老难题,发布首日看不出根治迹象。我的建议是不指望版本升级兜底,指令习惯先改起来,哪个版本都吃这套。
改图和生成新图,哪个更容易翻车?
改图翻得少。生成一张全新场景,镜子里的内容、手指姿态全靠它自由发挥,雷区更多。改图好歹有一张底图托着,只要指令圈死范围,它照抄底图的部分基本不会出幺蛾子。