AI算法修图怎么「看」照片?写给普通人的算法白话课
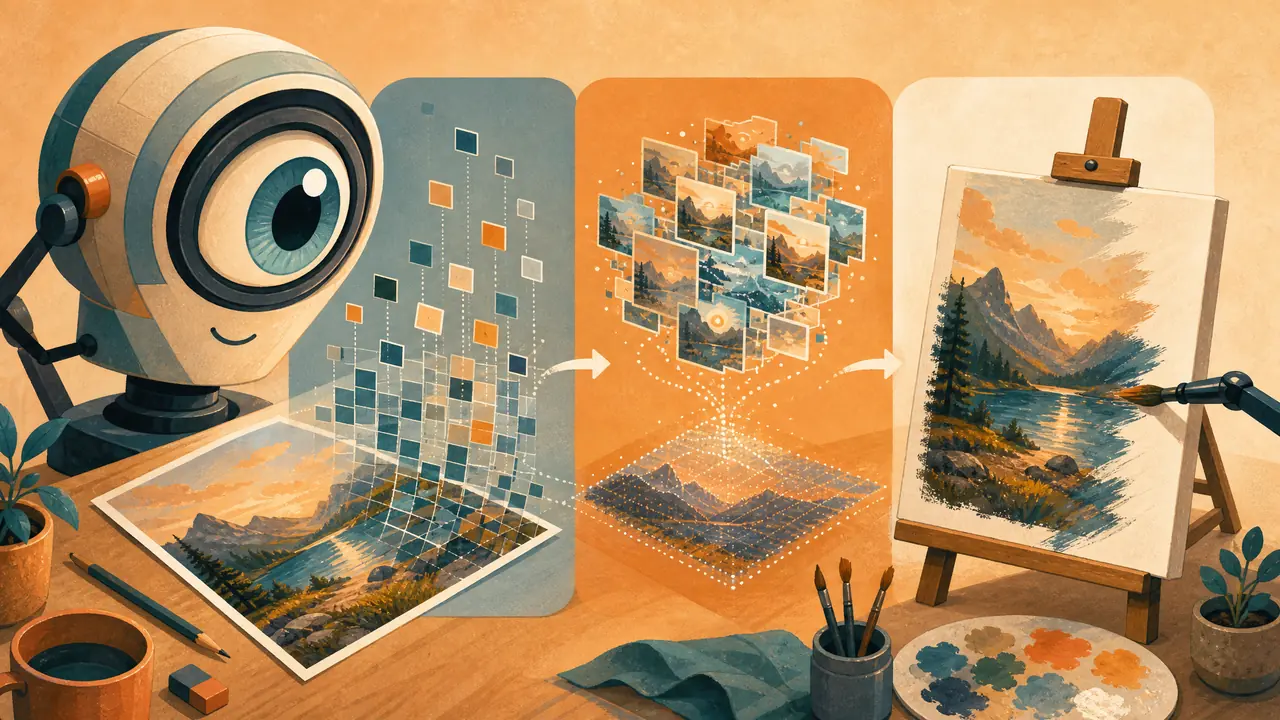
三步讲完:AI算法修图就是先看懂照片,再按概率想象,最后重新画出来。它不是在"优化"你的原图,而是在照自己的理解重画一张。看完这三步和三个小实验,你打开修图软件时就知道哪些活能交给它、哪些地方必须自己把关。
第一步:AI是切块看照片的,不是整张看
AI算法修图的第一步是不看整体,把照片切成很多小块,一块块找认识的特征,再拼出整体理解。你手机相册搜"海边"能一口气翻出几百张海边照,靠的就是这一步。
人扫一眼一张照片,是一整口咽下去的:湖、天、人、光线,同时到脑子里。算法不一样。它是把图切成密密麻麻的小格子,一个格子一个格子地问:这里有条边吗?有块绿色吗?有重复的纹理吗?认完零件,再往上拼出"这是湖边黄昏"这样的结论。
今年8月我干了件挺无聊的事,你可以照做:拿一张自己在青海湖拍的照片,用手指一点点挡住画面的不同角落,看识图工具的描述怎么变。挡住左下角那串经幡,描述一个字没变,它根本没拿经幡当重点。挡到上面那片天,"蓝天"两个字立刻从描述里消失了。也就是说,它的"看懂"是零件拼出来的,哪块零件没了,对应那句就说不上来。
我写过几年图像分类的代码,后来主业换成了拍照,两边都待过。要说感受,就一句:人对照片的理解是先有画面再挑细节,AI是先数零件再硬拼画面,顺序完全是反的。它像个只研究过几百万张拼图成品图、自己从没动手拼过的人——靠盒盖的印象,猜手上这块碎片属于天空还是湖面。
顺带说个反方向的小发现。我把那张青海湖的照片缩到很小——宽度只留320像素——再去认,描述反而更利索了,杂七杂八的干扰细节被甩掉,剩下的全是大色块。这个思路反过来也成立:为什么缩略图看着挺美的照片,一放大全是不忍看?因为它修图时盯的就是大色块那一层,你放大后挑的毛病,在另一层。
第二步:它脑补的不是你的照片,是"最常见的那种照片"
AI修图不是把原图恢复成什么样,而是照着见过的千万张图,挑一个概率最高的样子去猜。所以它给的结果稳定偏"大众脸"。
我做过一个不需要任何代码的小实验。找了四个朋友,只给他们听三个词——"湖边、长椅、傍晚"——让他们在纸上各画一张。四张纸收上来,四把长椅朝四个方向,天色也各不相同。没人见过现场,全在脑补。AI干的就是同一件事,只是它脑补时的参考,是训练时见过的海量图片里出现最多的那种组合。
同一思路我拿来试过补全,姑且叫补全实验。今年6月,我把一张街拍里路人的一角涂掉,让AI补上,同一个位置连补三次:一次补出帆布包,一次补出塑料袋,一次干脆什么都没有,直接是墙面。要是它真"看懂"了原图,答案就该稳定。三次三个样,恰恰说明它在想象,不在还原。
说到这儿我多嘴一句题外话——那三个版本我都留着,轮着当手机壁纸,居然都不难看。话说回来,这个实验也顺手解释了另一个常见现象:同一张图,你今天修和明天修,出来的肤色、天空颜色都有差别。因为它每回都是重新猜,猜的路径不同,落点就不同。你让它修人像,它给出的肤色永远是它见过的"平均值",偏不偏,看它吃进去的图里哪种人最多。
第三步都「画」出来了,为什么手指和文字还老画错?
画这一步是从一团模糊噪点起步,一遍遍往清晰收,手指和文字的变化太多,它没记够,落笔就容易崩。
你在软件里点一下"增强",背后是这么个过程:它从一团乱麻似的噪点开始,反复问自己"清晰版应该长什么样",几十轮之后定格成图。天空、草地、虚化背景这类它见过太多遍的东西,收得又快又稳,所以风光图的AI修图观感普遍好。手就麻烦了。五根手指的角度组合近乎无限,文字又必须一笔不错,它背不全,只能蒙,蒙错就多一根手指、少一撇。
今年7月我给客户修一张婚礼合影,新娘身后站着个穿红衣的路人,我想用某修图软件的"移除"笔刷把人抹掉。笔刷半径第一次调到40像素,一涂一松手:路人没了,可她手里那杯奶茶变成了一只橘猫。客户在微信上回了三个问号,我盯着屏幕也回了三个问号。第二次把涂抹范围缩到20像素、分两块涂,才算干净。那一单的前后对比图我留着没删,就当给自己的提醒:交片前,把AI动过的地方放大到200%,一处一处看过去。它的落笔处,就是它的错题本。
想往原理层再抠一步的,这篇AI修图原理拆解写得比我细,可以接着看。
看懂、想象、画出来,三步串起来,AI算法修图就没那么神秘了。它像个背过几百万张画的学生,出手快,路子正,但偶尔会非常自信地画错。你要做的不是去背参数,而是记住一件事:它给你的是"最常见",不一定是"你拍到的"。下次修完图,放大看看它的落笔处,你心里自然有数。
常见问题
AI算法修图会把我的原图改得面目全非吗?
看功能。锐化、提亮、降噪这类只在原像素附近微调,改动幅度小;名字里带"移除""重绘""生成"的,是整块区域重新画,改得就狠。动手前先看功能名,遇到后一类,留一份原图备份再操作,不算胆小,算习惯。
完全不懂代码,能自己判断一款修图App的算法靠不靠谱吗?
能,用一张"试刀图"就行。挑一张同时有文字招牌、有人手、有栅栏或砖墙这种重复纹理的照片存着,测新App时每个功能都跑一遍:文字没糊、手指数对、栅栏条没扭曲,这款就及格。我手机里一直存着这么一张,两年换了七八个App,这张图试出来的结果和我后来实际用下来的体验基本没跑偏。
为什么同一次修图,AI每次给出的结果都不一样?
因为它每一轮的起点是一团随机噪点,从乱到清的路径会分岔,落点自然不同。想要可复现的结果,去设置里找"固定种子""锁定随机"之类的选项;没有这选项的,就多生成几次挑最好的一版,别指望第二次和第一次一模一样。
AI算法修图会偷看或者存储我上传的照片吗?
分两种情况。本地模型跑在你手机或电脑里,照片不出设备;云端服务要把图传到服务器处理,保留多久、会不会用于训练,都写在隐私政策里。用之前在政策页搜"保留""存储"这两个词,一分钟就能确认,别嫌麻烦。
延伸阅读
- AI修图逻辑观察:换个角度接着看AI修图的判断方式。