5080 AI修图实测:装机博主跑本地修图模型的显卡账
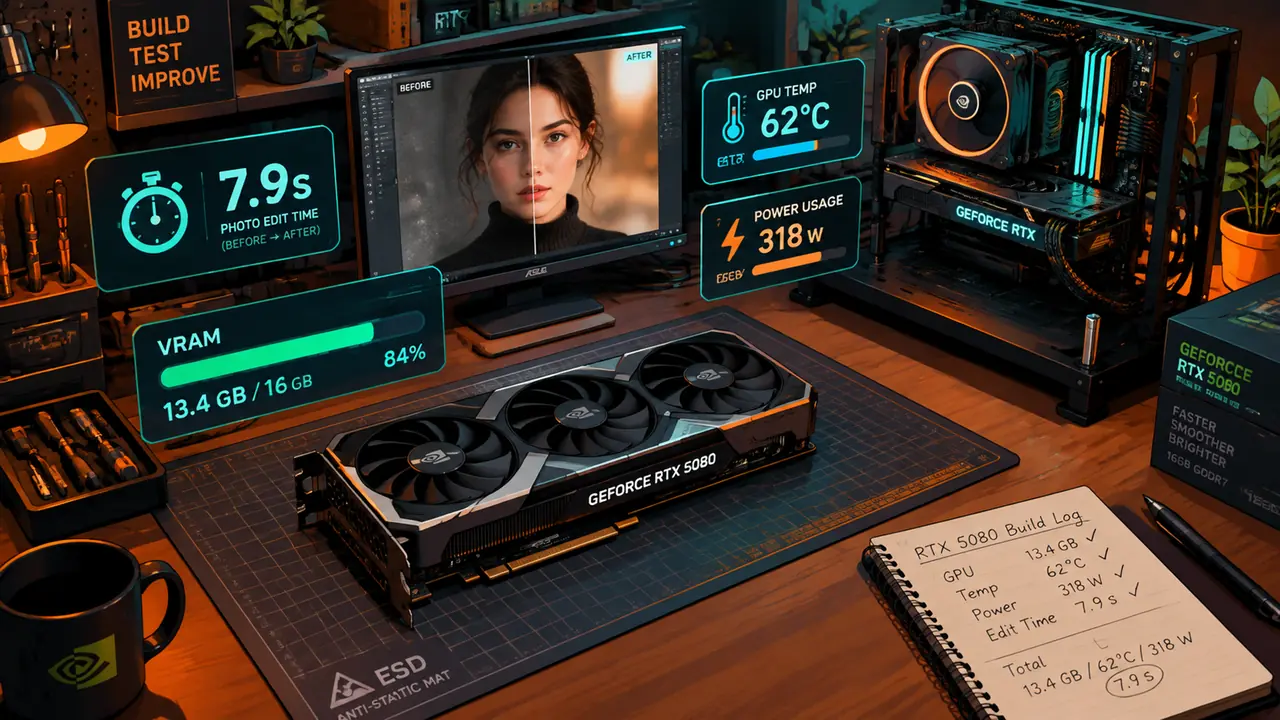
直接亮底:RTX 5080跑本地AI修图模型,速度提升实打实,卡不卡脖子看的是显存不是速度。同参数出图比4070 Super快近一倍,16GB显存跑Flux级模型刚好接得住,重活会溢出到内存。想换卡的,先想清楚自己平时跑多大的模型。
5080 AI修图这件事,我是在卡上市那周就上手试的——去年1月底5080刚到货,工作室测试台上还插着我自留的4070 Super。做装机这行两年多,评论区天天有人问"这张卡跑本地修图模型到底行不行",光靠猜没法回答,我干脆趁那批订单的空档,把两张卡在同一个平台上来回换着插,跑了整整三天,速度、显存、温度、功耗一笔笔记下来。结论先放这儿:快的部分超出预期,紧的部分也真紧。
出图速度:同一张图,它比4070 Super快了将近一倍
1024分辨率、30步采样的SDXL人像图,5080平均7.9秒出一张,4070 Super要14.6秒,换Flux模型差距拉得更开。测试条件我锁死了:9800X3D加64GB内存的平台,ComfyUI同一版本,DPM++ 2M Karras采样器,30步,CFG 7,batch跑20张取平均,排除首张冷启动那一次。SDXL这边5080跑出7.9秒,朋友的4080 Super借来测是9.8秒,4070 Super垫底14.6秒——提升幅度跟CUDA核心数量和频率的比例基本对得上,没有魔法。
真正拉开身位的是Flux.1-dev。这个模型对显存的胃口大,在12GB的4070 Super上必须把部分权重offload到内存,GPU利用率从95%掉到四成出头,20步一张要1分52秒,时间全耗在数据来回倒手上。5080全程权重驻留显存,20步26秒上下收工,你按一下出图键,泡半杯茶回来图已经躺在输出文件夹里了。模型加载速度也顺带受益:同一个11GB出头的Flux fp8文件,5080的机器从点加载到能跑大约14秒,4070 Super那台要将近半分钟。
说实话,让我意外的不是峰值速度,是稳定性。三天里连轴跑了六百多张,5080没有一次因为驱动或显存崩掉ComfyUI,这在上一代卡上市头几个月是不敢想的,当时40系新卡跑SDXL还遇到过闪退需要回退驱动的坑。
分辨率档位我也各测了一轮:1024×1024是7.9秒,1216×832横构图8.1秒,1440×1920竖版精修19秒上下——像素量翻倍,时间不止翻倍,因为采样之外的VAE解码和显存搬运都在加时。这套数字后来直接印在了给客户的配置单旁边,有位想开网店修商品图的姑娘看完,原话是"那我不省钱了",当场加钱上了5080。装机单里写实测秒数,比写"流畅运行"四个字有说服力得多,这是我这两年最实在的体会。
16GB显存到底够不够?我把模型一个个喂了进去
SDXL稳稳吃掉8GB上下;Flux fp8版本峰值13.4GB,16GB刚好接得住,分辨率再往上拉就会溢出到内存。显存这个东西,你可以把它想成厨房台面:模型权重是锅碗瓢盆,台面摆得下,菜出锅就快;摆不下就得一趟趟往隔壁屋(内存)端,速度全折在路上了。
实测账目是这样的:SDXL出图管线全开(主模型加VAE加ControlNet)占用8.3GB,台面剩一大半,你怎么折腾都稳。换成Flux.1-dev的fp8版本,单checkpoint就要11.5GB,加上T5文本编码器和VAE,峰值干到13.4GB——16GB接住了,但余量只剩2GB多。分辨率从1024×1024拉到1440×1920加二次精修,峰值逼近16GB,再往上就开始往内存溢,出图时间从26秒跌到一分多钟。
4070 Super那边我也照着喂了一遍:SDXL同样8GB级别毫无压力,Flux fp8一开就得靠offload续命,同样一个1440×1920的精修任务它跑了将近三分钟,硬盘灯闪得像心跳监护仪。所以在12GB卡上这不是快慢问题,是能不能按商单工期交付的问题。
翻车也要记一笔。第一晚我手贱下了fp16完整版的Flux,23GB的文件,加载到第9秒ComfyUI直接弹红框:CUDA out of memory. Tried to allocate 2.44 GiB,显存条只剩0.9GB可用,那一刻我就知道这晚白熬了。退回fp8才顺。理论上fp8有轻微画质损失,我放大对比了十几组图,肉眼基本分不出差别——这话只代表我这双眼睛,你要是出商业精修大图,建议自己再验一遍。
温度和功耗:修图一小时,电费一毛三
跑Flux时核心62℃、整卡平均功耗235W,一小时约0.23度电,按0.55元一度的电价算电费一毛三。用HWiNFO64全程记录,开放式测试台,今年8月底空调房室温26℃。
功耗曲线很有意思。AI修图是间歇负载:采样那几秒瞬时冲到265W,等待加载的间隙又掉回几十瓦,整段任务平均下来235W。对比跑3A游戏动辄330W往上的持续满载,修图对这张卡温柔多了。温度同步好看:核心稳定在62到66℃,热点最高79℃,GDDR7显存74℃上下。顺手提一句,GDDR7显存温度比上代偏高是普遍现象,我手上另一张帮客户装的5080也差不多这个水平,好在修图负载够轻,这点余量完全用不到焦虑。
算成钱更直观:235W乘一小时是0.23度,0.55元一度的民电,一小时一毛三。哪怕你一天修四个小时图、一个月跑满三十天,电费也就十六块上下,比一杯奶茶便宜。风扇转速全程六成左右,间歇负载带来的安静,比游戏满载时的呼啸好相处得多。
回到开头评论区那个问题:5080跑本地AI修图行不行,我的答案得分两半讲。只跑SDXL或者做轻量重绘,它快得让你懒得再开云端;要玩Flux这个级别的大模型,16GB是下限而不是舒适区,workflow里有大分辨率习惯的得更谨慎。卡是去年1月底装上台的,这本账我还在记,哪天驱动更新把显存调度优化上去,或者下一代卡把显存加到位,我再回来补一笔。
常见问题
RTX 5080跑本地修图,电源和其他配件要怎么配?
5080整卡设计功耗360W,修图虽然跑不满,850W额定电源还是要给足,接口认12V-2x6,别拿两根8Pin转接线凑合,瞬时限流会掉驱动。CPU配到9600X这个档位就够用,内存我建议直接上64GB——显存溢出的时候它就是救命的,32GB在Flux高分辨率任务里会被吃穿。
只有12GB显存的卡,还有必要折腾本地AI修图吗?
能玩,但边界清楚:SDXL生态随便跑,出图十几秒完全够用;Flux只能开fp8外加权重offload,速度掉到分钟级,体验是残血的。预算紧张的话,我的建议是把差价先花在内存和高速固态上,等下一代显存规格涨了再一步到位,中间这段时间用云端补足。
ComfyUI和Fooocus,新手第一次装该选哪个?
想打开就能出图的选Fooocus,界面傻瓜,模型下载完基本零配置;想修自己的照片、做局部重绘和换光的,直接上ComfyUI。装环境和下模型的时候照着软件修图AI怎么装一步步来,能少踩不少显存和路径的坑。
本地跑模型和按月订阅云端修图,长期算下来哪个划算?
按这套平台的实测功耗,一小时电费一毛三,就算天天修图四小时、月月跑满,电费也就十六块,比几十块的订阅费便宜得多。真正的成本是那张卡本身,以及你折腾环境的时间——偶尔修几张的人,订阅反而省心。