ai宫女绘画实测:博物馆唐俑文创插画的陶土质感与形制还原
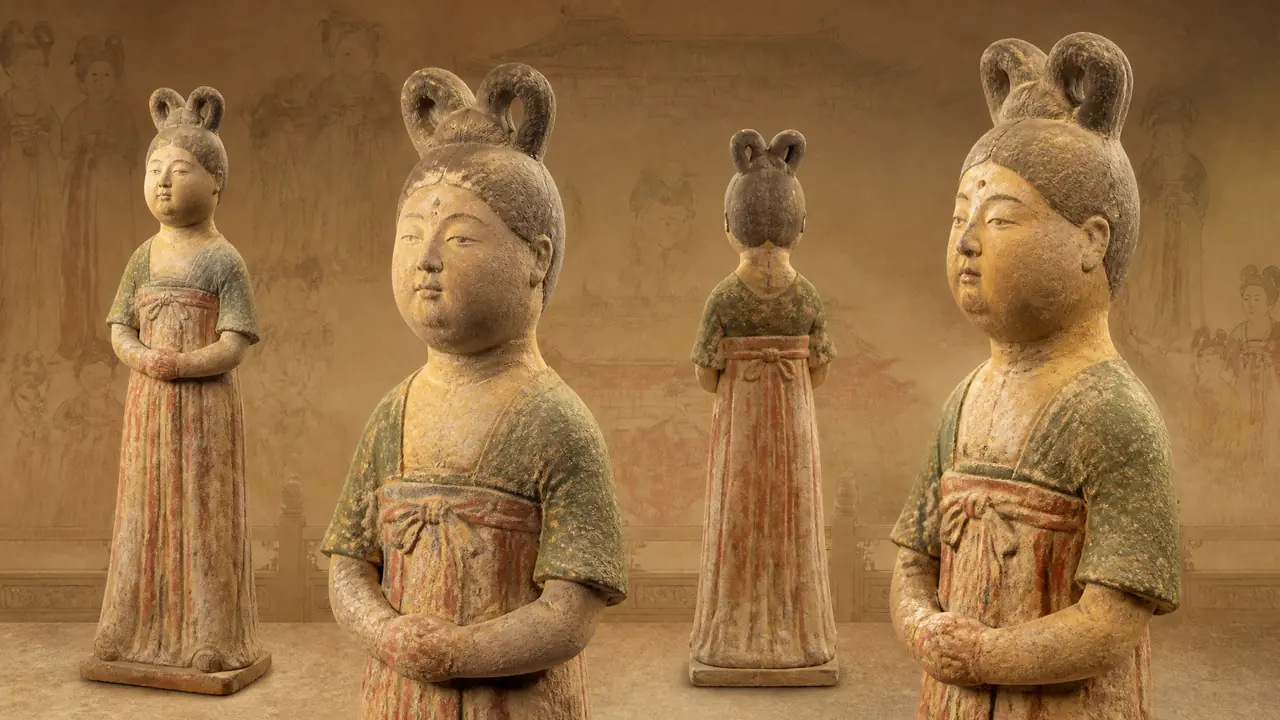
先把年代对准:ai宫女绘画要出的是唐俑,不是古风美人照。模型默认往网红古风和日式装扮上跑,锚点词钉不住陶俑语境,形制和质感全盘皆输。先抄文中的三段式提示词骨架,再按馆藏实物核对发髻与服制。
接手馆里唐俑文创这个项目之前,我对ai宫女绘画的印象还停留在社交平台上那些古风美人图。真拿它给唐代陶俑打设计稿,完全是另一回事。我的判断放在这:提示词只占三成功夫,剩下七成在形制核对和陶土质感的调教上,跳过这两步,出图再好看也过不了评审。
事情是这样的。2026年8月,馆里立项做一批唐代彩绘女俑的文创周边,帆布袋、冰箱贴、笔记本封面,插画部分落在我头上。馆长给的要求很朴素——让人一眼认出是我们馆藏的那几尊俑,别画成景区纪念品。预算撑不起外包插画(询过价,一张商用授权800到1500元,18张起步就是五位数),我决定用AI出方向稿,自己精修后送评审。
两个多月下来,废稿240多张,定稿18张,馆方评审挑走12款。下面把踩过的坑和调教记录摊开说。
提示词骨架:先钉器物,再钉朝代,最后钉形制
ai宫女绘画提示词分三段写:先用figurine和terracotta把画面钉成陶俑器物,再用朝代词压住年代,最后补双环髻、襦裙、半臂这些形制词,比堆形容词稳得多。顺序反了,模型就往人像写真跑。
我最早的写法很天真:"Tang dynasty palace maid, ancient Chinese costume, beautiful"。出的图确实好看,就是不对——建模脸、飘逸发丝、丝绸高光,活脱脱手游立绘,跟陶俑没半点关系。废稿里70多张都是这个路数。
转折点是把"人"换成"物"。写成 "Tang dynasty ceramic figurine, terracotta texture, museum artifact style",画面立刻沉下来,人物轮廓变敦实,表面泛哑光。再看几组实测对比:
| 提示词写法 | 出图倾向 | 我的评价 |
|---|---|---|
| palace maid + ancient costume | 古风美人、真人皮肤 | 废稿主力,弃用 |
| Tang dynasty figurine + terracotta texture | 陶俑器物感出来了 | 骨架词,每条必带 |
| 加 fat luo skirt, short banbi jacket | 襦裙半臂形制基本到位 | 十出六七,需筛选 |
| 加 double-loop bun(单写) | 时灵时不灵,常变丸子头 | 得配局部重绘救 |
还有个细节值得记一笔:词序影响权重。我把 "terracotta texture" 挪到提示词最前面那次,出图的土黄压过了彩绘,整张灰扑扑的,像出土没多久没清理的俑。放回中段,彩绘残留的赭红和石绿才回来。这类手感只能靠试,2026年9月那两周我基本在干这个。
陶土质感卡在"半陶半人"那条线上
陶土质感的难点是别把俑画成真人:哑光陶面加彩绘残留是底线,光比必须压平,侧光一强就变手办,质感词一弱就还原成皮肤。这条线比想象中窄。
翻车最频繁的就是质感。第一版图出来,脸是真人皮肤,带毛孔和高光,馆里同事看了说"这像cosplay定妆照"。我加 terracotta,又过头了——粗糙度拉满,出图像刚脱模的花盆坯,彩绘全没了。来回试了十几组,最后落在 "matte clay surface, faded pigment remains, slight wear" 这一串上,哑光打底,留一点褪色彩绘,意思才对。
光也是坑。出图默认爱打戏剧性侧光,俑的鼻梁和颧骨投出硬阴影,立体感是有了,但博物馆的俑是平光陈列的,影子一硬就像展柜里的收藏级手办。我在提示词里固定加 "even soft lighting, no dramatic shadow",才算压住。
质感调好之后还有个后续问题:图放大到印刷尺寸,陶面的颗粒感容易发虚发糊,这块我没少返工,排查思路参考了之前写过的那篇模糊ai绘画图糊了怎么办:出图发虚的3个原因排查与修复实测,本质都是细节密度不够。
形制核对别省:评审会上研究部老师一眼一个准
双环髻、齐胸襦裙、半臂这些形制词必须进提示词,出图后对照馆藏实物逐项核对。2026年9月的评审会上,研究部老师挑错全挑在形制上,画风问题反而没人提。
先说双环髻。唐代宫女俑标志性的双环髻,AI十次里七八次画成单丸子头,剩下两次出动漫风的双马尾变体。光写 bun 不行,我后来用 "double-loop hair buns on both sides" 加垫一张馆藏俑的参考图,命中率才勉强过半,不稳的就靠局部重绘修。
襦裙更热闹。齐胸襦裙的高腰线经常被模型自己加一条腰带结,位置和系法一错,整个观感往和服上偏。半臂也一样,短袖对襟的形制画着画着就成了现代马甲,领口还给你开成V字。我的笨办法是列一张形制清单:发式、上襦、半臂、裙腰位置、披帛有无,每张定稿对着馆藏照片勾一遍,缺哪补哪。
五官现代感是另一个隐形坑。模型默认往精致里画,眼睛大、鼻梁挺、下巴尖,网红脸。可唐俑的五官本来就简约概括,几乎就是捏出来的几个面。我在提示词里加了 "simplified facial features, serene expression" 才勉强拉回来。这段流程跟之前给成语之都文创设计插画时差不多——AI出方向,人工核形制,只是唐俑对"准"的要求更高,毕竟实物就摆在评审会桌上。
对了,幞头这事多说一句。唐俑里确实有女着男装、头戴幞头的形象,我本来想放进系列里丰富层次,写 "putou hat" 出来的图十有八九成了日式乌帽子,试了二十来张全废,最后这组方案整个放弃了。有些词模型就是没吃透,硬磕不划算。
回过头看,这个项目里AI干的是快和多的活,240张废稿里捞出18张能看的;而"对不对"这件事,从头到尾都得靠人盯着实物核。馆方12月上旬会把定稿的12款做成周边上架,冰箱贴打样已经回来了,陶土那层哑光印出来还原了七八成。你要是也拿AI做文物题材的插画,先把年代和器物感钉死,再谈好看。
常见问题
为什么ai宫女绘画提示词里写"宫女"总是出日式古装?
训练数据里和服、动漫古风占比高,单写宫女或palace maid会往那边偏。把画面锚定成figurine加terracotta,再压朝代词,日式元素明显变少,我的废稿率从七成降到三成左右。
陶俑风插画用于文创印刷,尺寸和分辨率给多少合适?
印刷按300dpi算,冰箱贴5厘米见方需要约600像素宽,帆布袋30厘米就要3500像素以上。AI原图普遍1024到2048像素,超出后必须用放大工具补细节,直接拉大陶面颗粒会糊。
双环髻反复画成丸子头,有什么补救办法?
先在提示词里写double-loop hair buns on both sides,再垫一张真实唐俑参考图控制方向。还歪就裁出头部区域做局部重绘,两三轮基本能修过来,我18张定稿里有11张动过这刀。
用AI生成的唐俑插画能直接拿去做文创周边吗?
两件事要分开看:平台商用授权按你订阅的条款确认;馆藏文物的形象使用要拿到馆方授权,我们是从立项起就走的正式合作。另外提醒一句,AI生成人脸类形象别用于冒充真实人物,这是底线。