AI绘画测试怎么做?出图前后要过的四道关
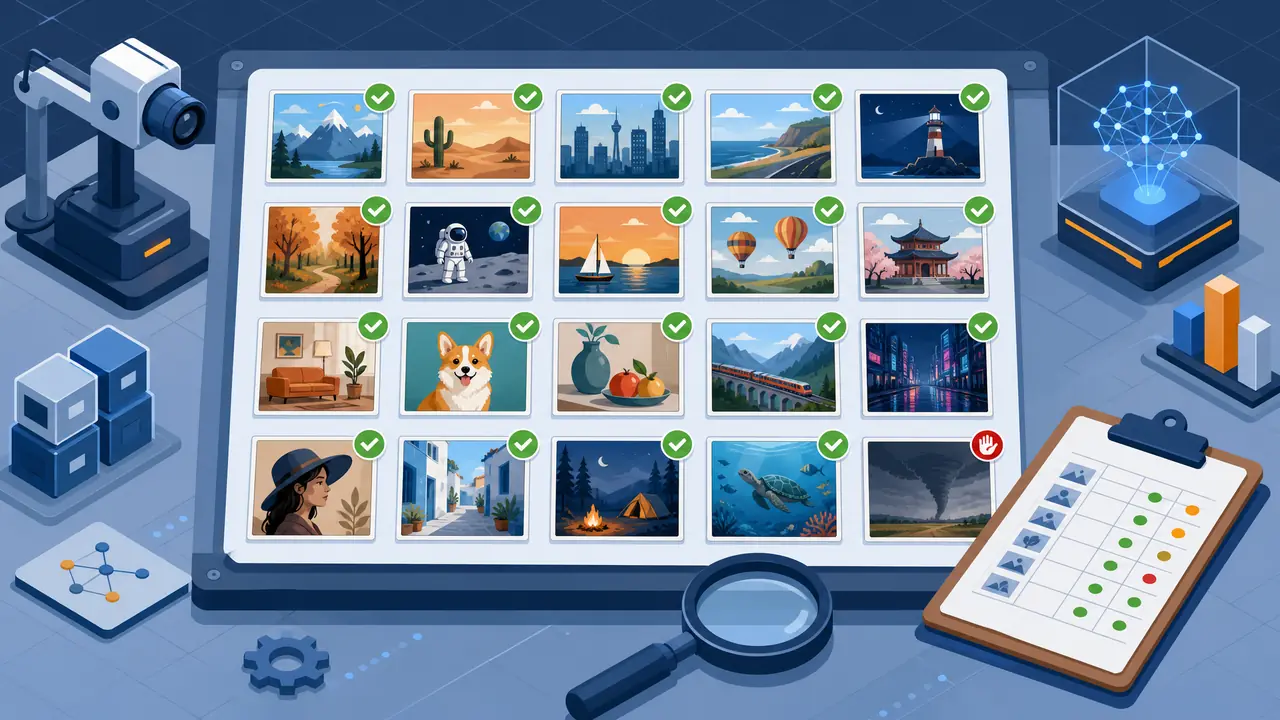
先说我的看法:AI绘画测试测三样——稳定性、风格一致性、边缘场景,方法是固定种子加固定测试集,跑完逐项打分。我以前做软件测试,这套流程搬过来之后,换模型前先跑一遍测试集,试错时间少了一大半。
AI绘画测试这件事,我是被一次换底模的翻车逼出来的。杭州这边做外包,2026年8月我把用了半年的底模换了个新版本,凭感觉挑了几张图看看效果,挺好,上线。结果客户那边批量出图时,三成图的手部全崩了。那之后我把以前做软件测试的思路搬了过来,搭了个小测试集,10月14日换新版模型时先跑了一遍,同样的坑一次没踩。
先给结论:测试不是给模型打分,是给你的工作流打分。模型好不好是模型的事,你的提示词、参数、后处理在它上面稳不稳,才是测试要回答的问题。
测试集怎么搭:20张图就够用
固定20张图的测试集:10张主场景、6张边缘场景、4张历史翻车图,种子锁死,每次换模型或大改提示词后整套重跑。半小时出结果,比凭感觉挑图可靠得多。
我的测试集构成不复杂。10张是最常见的出图场景,比如单人半身、全景、静物;6张是边缘场景,专门挑模型容易崩的:手部特写、多人同框、逆光、复杂纹样;剩下4张是历史翻车图——每次翻车我就把当时那张的提示词存进去,作为回归测试用例。这招跟软件行业的做法一模一样:修过的bug,必须变成测试用例。
种子锁死是关键。同一组提示词不锁种子,每次出图都不一样,测了等于没测。锁了种子,模型之间的差异、参数改动的影响,才能干净地比出来。
搭测试集还有个容易忽略的点:提示词存档要连参数一起存。我早期只存了词,换参数后想复现翻车场景,翻半天记录都对不上号,10月起连种子、CFG、步数一起存,复现一查就中。
四道关分别测什么
第一关结构稳定性,第二关风格一致性,第三关边缘场景,第四关参数敏感度。四关全过再上线,崩图率能压到个位数。
| 测试关 | 测什么 | 合格线(我的标准) |
|---|---|---|
| 结构稳定 | 手部、肢体、物件贴合 | 20张里崩图不超过2张 |
| 风格一致 | 同套提示词出10张的画风漂移 | 肉眼基本看不出漂移 |
| 边缘场景 | 多人同框、逆光、复杂纹样 | 6张里至少4张能用 |
| 参数敏感 | CFG上下浮动1的出图变化 | 变化平缓,不出现突变 |
9月那次翻车,复盘就是第一关没测:新模型对手部的处理比旧版差一截,我挑样图时恰好没挑到手部特写。现在四关跑完才敢说"新模型能用"。参数敏感度这关很多人不测,其实它决定你批量出图时参数的容错空间——敏感的模型,同样参数出十张能给你十种效果。
边缘场景的6张图里,有两张值得单独说。一张是逆光人像,专门测模型在强光轮廓下会不会把脸画糊;另一张是复杂纹样的服饰,专测细节会不会糊成一团。这两张图是8月换模翻车之后特意补进去的,当时客户订单里恰好就有逆光和纹样各一张,都崩了,钱倒是没赔,改稿改到半夜是真的。
测完之后,结果怎么用
测试结果落成三样东西:参数速查表、翻车黑名单、模型的适用边界说明。不落成文档,测了就白测。
我的习惯是每次测试完写一页速查表:这个模型在什么参数段最稳、哪些题材碰不得、跟上一版比退步了哪里。10月14日那次测试就发现,新模型出高清图的锐度好了不少,但复杂纹样题材明显变差,于是纹样类的单子我留在了旧模型上跑。速查表就贴在工位旁边,接单看一眼再报价,心里不发虚。
对了,画质增强和放大环节也值得单独测一轮。放大算法对细节的补全方式差异不小,我在AI高清绘画那篇里写过放大环节的对比,测试思路是通的,先把主模型测稳,再测放大链路。
最后提一句:测试集里的图别用客户稿件,用你自己生成的、没有版权纠纷的素材,翻车图存档时也把客户信息抹掉,这个习惯省了不少麻烦。
现在每换一次模型,跑一遍测试集,二十来分钟,一张表就摆在那:能不能换、换什么参数、哪些单子别碰。9月那种上线才发现崩图的狼狈,之后再没发生过。测试说到底就是花二十分钟,买一个"心里有底"。这张表现在换到谁接手都能看懂,比口头交接靠谱多了。
常见问题
AI绘画测试需要多少张测试图?
20张就够日常用了,重点是覆盖主场景、边缘场景和历史翻车图三类。数量太多测得累,反而坚持不下来。
不锁种子能测出稳定性吗?
不能测准确差异。不锁种子时随机波动会盖过模型和参数的真实差异,先锁种子比单项,再看随机跑的表现,两步分开做。
测试通过的模型还会翻车吗?
会,测试只能覆盖见过的场景。所以每次翻车后要把新翻车图补进测试集,让它变成回归用例,覆盖面才会越滚越大。