ai绘画 模块怎么搭?本地部署玩家的流水线实测
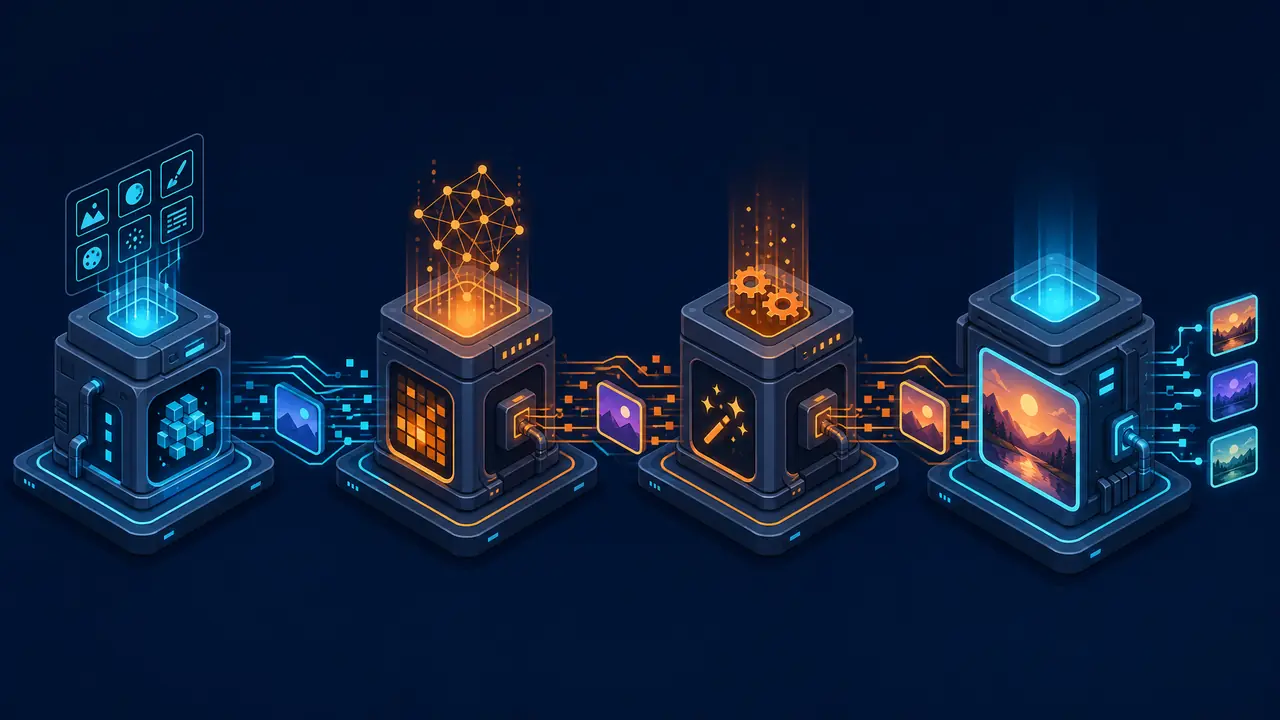
先把流程拆开:本地部署玩ai绘画,别一张图从零调到尾。把出图流程拆成底稿、上色、放大、修手四个可复用模块,串成流水线,参数调一次能反复用一个月。我在RTX 3060 12G上实测,同一套20张的图,从一个晚上压到一个半小时。你先照后面给出的显存参数搭,别上来就开2倍放大。
先交代清楚,这篇文章说的ai绘画 模块不是游戏里那个mod图标,也不是提示词模板库。我说的是工序层面的模块:把"出一张图"拆成底稿、上色、放大、修手四段,每段单独调好封起来,用的时候一段接一段往下传,像加工厂的流水线。
为什么非拆不可?今年8月之前我一直是个"一张一调"的原始人。接了个帮朋友画20张角色立绘小样的活,每张都从选模型开始、提示词从头敲、放大手动跑,一晚上(差不多三个小时)只攒出11张能看的。剩下9张不是手崩就是糊成马赛克。第二天盯着ComfyUI里那堆翻来覆去重连的节点,我突然想通一件事:我每次连的,其实是同一套东西。
出图流程怎么拆成四个模块
出图流程按出错频率拆:底稿管构图、上色管风格、放大管清晰度、修手管局部返工,四段各封一个模块,参数一次调好反复调用。哪段最容易翻车,哪段就单独成块,边界按翻车记录划。
我不是按教程拆的,是按翻车频率切的。翻车多的段落单独拎出来,方便定点返工,这就是流水线真正的好处。四段的分工摆开看——
| 模块 | 干什么 | 单张耗时 | 显存峰值 | 我的评价 |
|---|---|---|---|---|
| 底稿 | SDXL底模出构图草稿 | 8秒上下 | 6.8GB | 最省心,搭好基本不动 |
| 上色 | ControlNet接线定风格 | 15秒上下 | 7.5GB | 换风格只换这一段 |
| 放大 | 分块放大补细节 | 1分10秒 | 9.4GB | 坑全在这段,下节细说 |
| 修手 | 检测到手就局部重画 | 20秒(含检测) | 7.9GB | 触发条件是命门 |
耗时是2026年9月跑那套立绘小样时记的平均值,机器是RTX 3060 12G、32G内存,ComfyUI便携版。批量小图上这套思路更吃香,之前写过一篇学生手抄报配图用AI打小样的实测,11张图从两小时压到45分钟,路子是相通的,只是模块切得比我粗。
底稿和上色模块先把参数钉死
底稿模块锁死模型、采样器和步数,上色模块只留风格一个变量,两段调好之后日常出图不用再碰,换风格时把上色段整段搬走。变量越少,流水线越稳。
底稿我定的是SDXL底模、DPM++ 2M Karras、25步、CFG 6.5,出图1024x1024。这组数我试过一轮:20步速度快但构图毛糙,30步往上跟25步几乎看不出差别,纯属白烧显卡。定死之后,底稿段半个月没动过。
上色段是整个流程里我最偏心的一段。ControlNet走lineart,权重0.75,再挂一只赛璐璐上味的LoRA。这套组合出来的图干净,线是线、色是色。说实话我试过把权重拉到0.9,风格是稳了,可底稿的构图被压得死死的,改个姿势都不听使唤,0.75是个还能商量的数。
串联第一晚的惨案就发生在这段。当时ControlNet的权重线忘接,20张图跑出来全是灰块,我一度以为是模型坏了,删了重下了两遍。后来才发现是连线问题——模块化最坑的地方就在这:一段断了,后面全白跑。现在我用中间图落盘当保险,每段输出都存PNG,断在哪一眼就能看出来。
放大模块的显存坑
放大模块别开2倍整图直出,12G显存会当场爆掉,改成768分块加64像素重叠,显存峰值从11.6GB压到9.4GB。接缝问题靠重叠像素解决。
这个坑是我拿真金白银的等待时间换来的。2026年9月中旬第一版放大模块开2倍直出,跑到一半直接报CUDA out of memory,任务管理器里显存冲到11.6GB顶死。改成分块放大,1024的块还偶尔炸,一路降到768才彻底稳住,峰值9.4GB,还留了点余量。
重叠像素这个参数很多人忽略。我把overlap设成64,分块接缝基本看不出来;试过32,接缝处能瞅见一道淡淡的色阶,放得越大越明显。宁可多花几秒,也别省这32像素。
放大完发虚也别急着骂模块。发虚的来头不止显存这一个,采样器、步数、放大算法三个原因我在这篇模糊ai绘画图糊了怎么办的排查实测里挨个排过,不少时候锅其实在底稿段。
修手模块什么时候触发
修手模块只在检测到手且置信度低于0.55时才二次重画,阈值0.7一次不触发,降到0.45后每三张逮住两张坏手。没手就不跑,一张省20秒。
修手段我用的是手部专用检测加局部重画的组合。触发条件有讲究:检测置信度我一开始设0.7,心想高阈值肯定准。结果20张图它一张没触发——阈值太高,它觉得每只手都"还行"。降到0.45之后才正常干活,实测每三张能逮住两张坏手,剩下那张是真没救,直接回底稿重roll。
阈值压太低也有代价。0.45偶尔会把袖口、握着的东西当成手,白跑一轮检测多花20秒。我的取舍是认下这个误判,比放过坏手划算。
修手段排在流水线最末端是有原因的:它得等放大完再动手,不然放大一糊,修好的手又白修了。顺序别乱。
回到开头那20张立绘小样。9月底我用搭好的流水线重跑了一遍同规格的活,1小时40分钟全部出完,能用的18张,比8月底那次多7张还快一倍。模块化最妙的地方在于,麻烦是一次性的,省事是每一天的。本地部署玩ai绘画,先把流程拆开,再谈参数,这个顺序别反。
常见问题
搭这套模块化流程需要写代码吗?
不需要。ComfyUI里把节点按段框选分组、存成工作流文件就行,我的四个模块就是四个分组,拖出来改两个参数就能复用,全程没碰过代码。
8G显存的卡能跑这四个模块吗?
能,但放大段得再收敛:分块降到512、倍率压到1.5倍,底稿换SD1.5系的模型。跑是能跑,单张耗时会翻倍,20张一套得三个小时往上。
模块之间怎么传图?
两种一起用:节点直接连线保实时,另外每段输出落盘存PNG当保险。串联那晚全灰块的教训就是这么换来的——光靠连线,断一段后面全白跑,落盘才能一眼定位断点。
想换画风要动四个模块里的几个?
动一个就够。只换上色段的ControlNet权重和LoRA,底稿、放大、修手三段的参数原封不动,这也是当初按风格切模块的原因。