模特平铺图ai口令合集:女装店主验证过的6条可复制口令
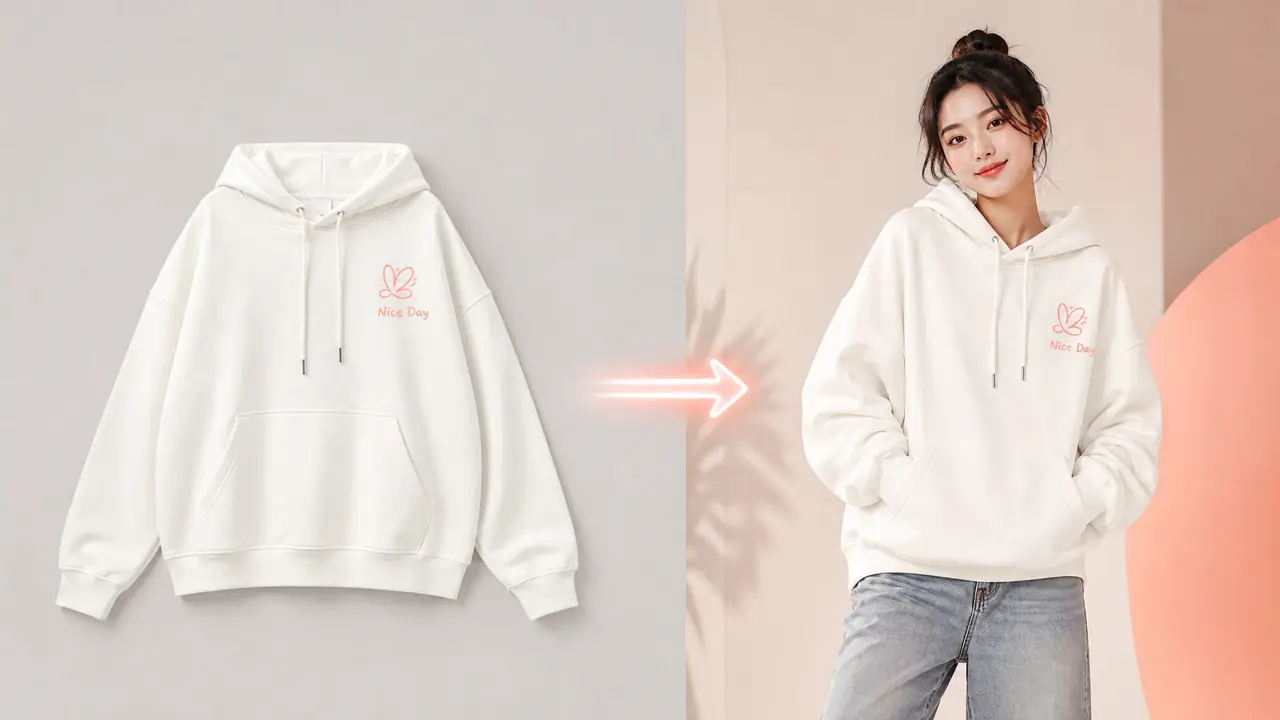
先说结论:平铺图转真人模特图,口令比工具重要。六条口令按品类分好,复制改词就能用。先拿一件卫衣试跑,成了再批量铺开。
模特平铺图ai口令,说穿了就是把挂拍或平铺的商品图变成真人上身图的指令。口令给得全,一张平铺图十五秒就能变出能上详情页的成片。
我在广州做了六年女装,档口出货快,拍摄永远跟不上。请一次模特加摄影棚,一天两千打底,上新密的月份根本烧不起。去年底开始琢磨AI转图,头一个月全是三只手、裙腰拧成麻花的废片,删到怀疑人生,后来才摸出口令的门道。
平铺图喂进去为什么全是"假人"
平铺图信息量太薄,AI只能靠猜补出人体结构,猜错就畸形。口令要补的是版型、材质和姿势三样信息,缺哪样翻哪样。这不是玄学,是信息量的问题。
平铺图只有衣服,没有肩线、腰线和透视关系,AI拿到手只能自己编。编得好是惊喜,编得差就是恐怖片。我第一版口令特别短,就写"让模特穿上这件衣服",十张里八张脸是糊的,手别在袖子里出不来。
后来把口令拆成三段:前段写人,年龄、身材、肤色;中段写衣,版型、材质、颜色;尾段写景,背景、光线、机位。成功率一下从三成拉到八成。你抄我下面这些口令的时候,三段的位置别乱动,动一段崩一张,这是拿四十多张废片换来的教训。
六条口令直接抄,按品类替换商品词
六条口令按品类分好,复制后只需替换括号里的商品词。卫衣、连衣裙、裤装、套装各一条,外加修手和改背景两条救场口令。都是我店里实测过的版本。
先说主力四条。卫衣款写"真人女装模特,二十出头,身材匀称,上身穿着图中的宽松卫衣,下搭直筒牛仔裤,自然站姿,双手插兜,纯白影棚背景,柔光,正面半身构图"。连衣裙款把下装换成"裙摆自然垂坠,走路带风的状态",背景换成"奶油色布景,窗边光"。裤装款必须写明"九分长度露出脚踝,单手轻拽裤缝",不写这条,AI爱把裤腿无限拉长,比例全崩。套装款则要交代"西装面料挺括,手拎小包,街拍背景虚化",不然外套和裤子容易融成一件。
| 编号 | 用途 | 口令核心(复制后替换括号内容) | 实测情况 |
|---|---|---|---|
| 01 | 卫衣上衣 | 真人模特穿着图中的(商品名),双手插兜,白棚柔光,半身正面 | 最稳,四十张里成了三十三张 |
| 02 | 连衣裙 | 模特走动中裙摆扬起,奶油色布景,窗光,全身构图 | 动态容易糊脸,七成能成 |
| 03 | 裤装 | 九分裤露脚踝,单手拽裤缝,灰底影棚,站姿自然 | 稳,几乎不挑图 |
| 04 | 套装 | (面料)套装,手拎包,街拍背景虚化,七分身构图 | 背景太杂时换回白棚 |
| 05 | 修手救场 | 画面其余保持原样,仅修复手部,五指自然分开 | 能救回六成废片 |
| 06 | 换背景 | 保留人物与服装不动,背景替换为(街道/影棚/家居) | 只动背景才不出戏 |
后两条是救场用的,别小看它们。一个款roll八张是常态,挑两三张能用,剩下的废片多半就废在手上和背景上,有这两条口令捞一把,成片率又能往上抬一截。
口令之外,三个细节决定成片率
口令只管七八成,剩下的靠垫白底、压分辨率和局部重roll。出畸形别急着删图,圈住手部重roll两次,基本都能救回来。这三件小事比换工具管用。
第一件,平铺图先垫白底。手机随手拍的平铺图边上带着木地板纹理,AI会把纹理当成衣服的一部分,出图就花了。我现在固定流程是先抠图垫纯白底再喂AI,废片率肉眼可见地往下掉。
第二件,分辨率别超。我踩过的坑:传四千像素的原图,排队二十分钟,出来还是糊的。压到一千五像素左右再传,十几秒出一张,清晰度看不出差别。
第三件,翻车别整张删。上周五晚上赶新详情页,连衣裙第七张模特右手六根手指,我盯着屏幕气笑了。圈住手部单独重roll,第二遍就正常了。整张重roll反而把好端端一条裙子也换了版型,得不偿失。话说回来,这套流程跑熟之后,我一晚上能磨出一整套详情页的量,比等档期拍照快太多了,就是费眼睛。
平铺图转模特图这件事,工具是谁家的真不重要,口令给足信息才出片。先用这六条跑一遍你店里的爆款,跑顺了再按自己的品类改词。改的时候记住三段式:人、衣、景,一段都别省。
常见问题
口令用中文还是英文?
用即梦、可灵这类国产工具,中文口令直接贴。走Midjourney的话把口令翻成英文,结构不动,还是人、衣、景三段。
一个款要生成几张才够用?
我的习惯是一个款roll八张,挑两三张能用的。上新密的日子一晚上roll四五十张,挑到手软,但比约拍省太多。
平铺图上带着吊牌要紧吗?
要紧。吊牌会被当成衣服的一部分画进图里,长出奇怪的布片。传图前把吊牌剪掉,或者后期修干净。
出来的模特脸够用吗?
详情页小图完全够。做主图大图的话避开脸部特写,用半身或全身构图,脸糊一点也看不出来。