迅雷ai绘画这个组合怎么用:老下载党的模型搬运实测
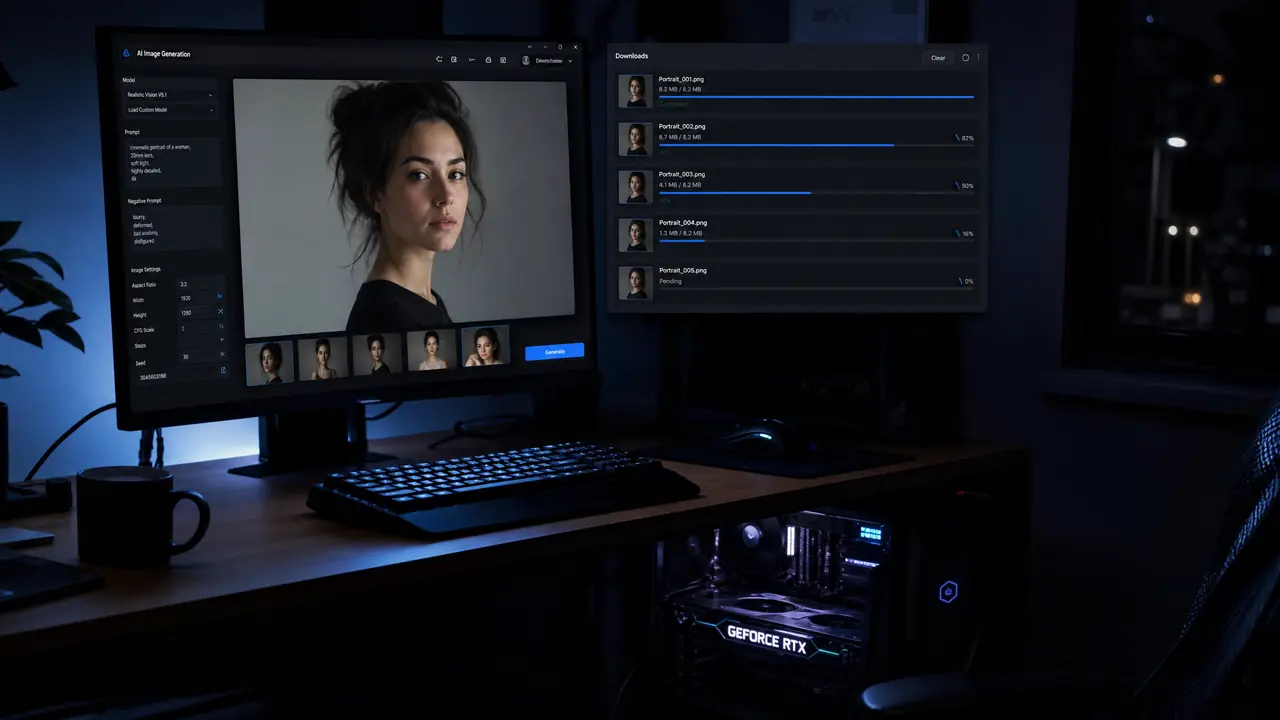
丑话在前:迅雷和AI绘画没有官方联名,它在这件事里的角色就是搬运工——搬那几个G的模型文件。搬运这件事它干得不错,四十分钟落地一个7GB模型,但下载完的校验、部署、跑图,一步都省不得。
迅雷ai绘画这组词,搜索的人多半是想找一条捷径。我的回答先给出来:没有捷径,只有搬运。AI绘画的模型文件动辄五六个G,官方渠道的下载速度对国内的网络不算友好,老下载党的办法是把迅雷当运力用。这一篇就把这条运输线讲透。
我的情况:济南后端程序员,公司配的工作机加家里一台3070的台式机,本地跑AI绘画两年,陆陆续续下了二十多个模型,走迅雷的占一半。写这篇之前,群里还有人问"是不是真有迅雷牌AI绘画",我笑着把这个问题记了下来——这就是这篇要拆的误会之一。最近一次完整实测是10月13日晚上,正好把这条流程的每个环节都记了数。
速度实测:离线下载比直链快五倍
官方直链每秒两兆出头,扔进迅雷离线下载能拉到每秒十一兆,7GB的写实模型从两小时压到四十分钟。10月13日的实测过程:同一个7.2GB的写实人像模型,先试官方直链,浏览器挂了二十分钟下了2.4GB,速度在每秒1.8到2.3兆之间晃;换成迅雷,把直链扔进离线下载,云端秒取完,再取回到本地,稳定在每秒10到12兆,全程四十来分钟。20GB出头的大模型按这个速度就是两小时上下,睡一觉的事。顺带一提,晚上十一点后的取回速度明显快过傍晚,公司下班和小区宽带的高峰期是错开的,这个规律我实测过三回,都成立。
来路不明的模型,校验一步都别省
下载完先对哈希值再双击,来源页面给的校验和与文件对不上就删,这一步挡住的是伪装成模型的恶意文件。我踩过一次虚惊:9月底从一个论坛的转载链接下了一个模型,6.8GB,哈希值和发布页对不上,发帖人自己也说不清来源。我直接删了,重找原作者的发布页重新下。模型圈的水比想象深——有的转载文件被塞过捆绑脚本,双击安装的时候悄无声息装一堆东西;有的老模型授权写明仅限个人使用,商用直接踩版权线。我的固定流程是三步:只从原作者的发布页拿链接、下载后对一次校验和、用之前查一眼授权条款。三步加起来十分钟,比中一次招的代价便宜太多。这里也得说句实话:迅雷本身不管这些,它只管把文件运到你硬盘上,运来的是什么全看你自己。
模型落地之后,本地跑图的门槛
8GB显存是能出图的底线,写实模型建议12GB起步,我的3070出一张1024的图八秒上下,这个速度值不值一套显卡钱,看你出图量。具体账:3070是8GB显存,跑写实模型开中等精度够用,出1024乘1024一张八秒;换12GB以上的卡能把精度开满,细节和手指的正确率肉眼可见地涨。内存16GB够用,硬盘留出两百GB——模型这东西下起来就没完,我现在两个盘都塞满了,正在纠结删哪个。部署也不难,现成的整合包解压就能跑,真正花时间的是调参:同一个模型,采样步数从二十调到三十,单张多花三秒,质感涨一截,这个取舍每张图都得自己掂量。本地跑图和网页版的关系也说一句:不是谁取代谁,出图量大、要批量、怕隐私,本地;偶尔画两张、懒得折腾,网页版。我的分配是工作项目走本地,帮朋友画着玩走网页。
再补一个只有本地才有的体验:跑图不受别人排队影响。十月中旬那阵网页平台一到晚上就排队,我这边本地挂着批量任务,四百多张参考图一夜出完,第二天早上挑图。这种"机器替我上夜班"的感觉,是本地部署最上瘾的地方,也是这套搬运流程真正划算的原因——模型搬一次,用一年。
二十多个模型搬下来,我对这条流程的总结就一句话:下载是整个链条里最简单的一环,难的都在下载之前的选择和下载之后的校验。迅雷干好了它的搬运工本分,剩下的活,是你的本分。下一个想试的三国风模型发布页我刚收藏了,等周五晚上挂上,周六早上出图。
常见问题
迅雷下载的模型文件后缀是别的格式怎么办?
先看清楚再改后缀。有些下载任务被自动改名,确认原文件格式再手动恢复,别直接双击——格式不对的文件混进来,十有八九是有问题的搬运。
下载速度突然掉到几百KB是为什么?
多半是取回阶段的节点高峰,换个时段重试,或者把任务暂停重新开始。我遇到这种情况一般是切了网络时段,十一点后基本都恢复。
模型下好了,出图还是慢怎么办?
先查精度和分辨率设置,再查是不是后台挂着别的占显存的程序。我同事的一台机器出一张图要四十秒,关掉一个挂着视频会议的浏览器窗口,速度回到十秒。