ai模特如何生成?从噪点脑补成图:扩散模型原理与自己变模特的边界
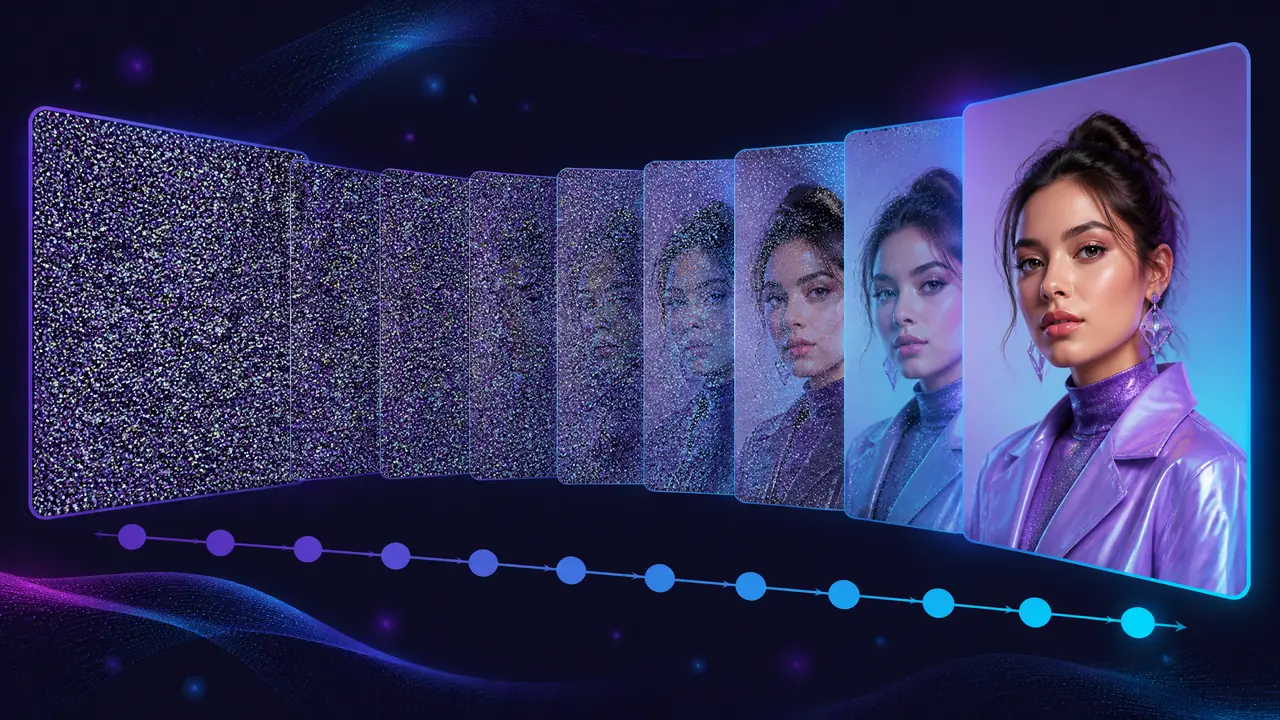
先把机制讲明白:AI模特图不是拿哪张真人照片「改」出来的,是扩散模型从一整块随机噪点里按提示词方向逐步「去噪」脑补而成;同一句提示词每次出图都不同,根源在起点噪点由随机数决定。想拿自己照片变模特可以玩,但只玩自己的脸,别碰他人形象,发布记得亮明AI身份。
ai模特如何生成?后台隔三差五收到这个问题,追问的第二句往往是:是不是偷了哪张真人照片来改的?答案放在最前面:不是。一张AI模特图从诞生那一刻起,底稿是一整块没有任何画面的随机噪点,整张图是模型从噪点里一点点「脑补」出来的。
我写科技稿这行干了些年头,AI绘画这条线跟了三年多,从早期的GAN一路看到现在的扩散模型。这篇不讲操作,专讲原理:模型怎么把噪点变成图,随机性藏在哪一环,「用自己照片变模特」这条最火的玩法线又划在哪。讲原理有个好处——机制吃透了,工具明年换几轮皮,你心里都有底。
AI模特图是怎么生成的:从满屏噪点里「脑补」出一张图
AI模特图靠扩散模型生成:从一整块纯随机噪点出发,按文字提示一步步去噪,几十步后雪花屏收敛成清晰人像,全程没有照片底稿。
先说训练。扩散模型「上学」的方式有点反直觉:往图片上撒噪声。拿一张模特图,分成上千个小步慢慢加噪,加到最后一步,原图彻底沦为雪花屏。模型要做的题只有一道——盯着某一步的「半坏图」,猜出回到上一步干净一点的样子。这道猜图题在数以百万计的图片上反复练,模型把「人在画面里通常怎么长、光从哪边来、布料怎么垂」这些规律,一点点压进了自己的参数里。
生成就是把这个过程倒着放。你敲下一句提示词,系统先掷一次骰子,掷出一整块纯噪声当起点;文字先被翻译成一组「路标」,去噪的每一步都朝着「更像这句话描述的画面」挪一小格。我头一回真正看懂这套机制,靠的不是论文,是一段三十秒的去噪延时视频:画面从雪花屏到成形,前几步定构图和色块,中段长出肢体和服装,最后几步才精修发丝和皮肤质感。那感觉像看老式胶片在显影液里浮出影像,一层一层来,急不得。
电商爱用AI模特图,看中的就是这套机制的规律性。人对自己的长相太熟,模型练人像的样本又最足,出图成功率在所有题材里排得上前列。规律性强也意味着它会犯「规律病」——手的姿势千变万化,规律最难压,所以手指是它最容易露怯的部位,这属于原理自带的脾气,不怪你提示词没写好。
科普这几年被问最多的几个问题,我拢成一张表放在这儿:
| 原理问题 | 通俗解释 | 常见误解 |
|---|---|---|
| 图是从哪张原图变出来的? | 起点是纯随机噪点,没有底稿,画面按提示词从零「长」出来 | 以为AI偷了某张真人照片去修图或换脸 |
| 模型记住训练图片了吗? | 它存的是海量图片压出来的统计规律,不是能翻看的图库 | 以为模型里内嵌一个可检索的相册 |
| 提示词写得越细就越准吗? | 提示词只管方向,压不住随机性,写再细也锁不死画面 | 以为描述够长就能得到想要的那一张 |
| 为什么手指、饰品老出小毛病? | 手和配饰形态太多样,规律最难学,去噪时容易走样 | 以为模型坏了,其实是原理自带的短板 |
为什么同一句提示词,每次出的图都不一样
随机性藏在起点:初始噪点由随机数(种子)决定,种子一换,去噪每一步落点全变,同一句提示词照样一张图一个样。
道理拆开讲很简单。生成那张图的第一块噪声,是程序当场掷骰子掷出来的。骰子点数不同,去噪走的路径就完全不同,最后收在哪儿算哪儿。同一段提示词连跑十遍,等于掷了十次骰子,出十张不一样的图——这不是故障,是机制本身。
骰子有个编号,行话叫种子。我做过个小实验:同一段提示词、同一个模型版本,放开跑,十张图十张脸;把种子固定成同一个数字再跑,连发丝的走向都分毫不差。搞懂这一层,「抽卡」就好理解了——你每点一次生成,本质是在换种子抽奖;反过来,哪张图想稳定复现,把它的种子记下来就行,那是那张图的门牌号。
顺手解开一个常见的委屈:很多人抱怨「AI不听话,我要的姿势它死活不给」。从原理看,提示词是路标,种子是起点,这两样本来就不负责「精确复刻」。想要精准控制,业内的路子是垫一张图定构图、圈一块区域局部重绘,把随机空间一点点锁小——跟把提示词加长到两百字没有关系。
「自己变模特」的玩法很上头,边界得先划清
拿自己的照片生成自己的模特照可以玩,肖像权是自己的;拿他人照片生成形象去商用或冒充,踩的是肖像权红线;公开发布要按平台规则标注AI生成。
原理讲完,就能接住另一半提问:能不能把照片丢进去,让ai自己变模特,给我出一套「杂志大片」?这大概是眼下最火的C端玩法。机制上它和上文是同一件事——你的自拍照在这里不是被「修图」,而是当了去噪过程的参照,模型照着这张脸的规律去收画面。玩法体验和隐藏账单,之前写过一篇特效App实测(照片模特ai特效为什么火?个人用户玩特效前要算清的三笔账),这里只谈线划在哪。
第一条线:自己的脸自己用。肖像权是一项「自有」的权利,本人的肖像本人处分,拿自己的照片生成自己的形象,自娱、发朋友圈,一般不构成对谁的冒犯。真正要留心的是数据去向——正脸照交上去,等于把生物特征交给了服务商,上传前看两眼隐私条款:照片会不会被拿去训练、能不能删、给不给第三方。这是隐私账,跟肖像权账是两本,别混着算。
第二条线:别人的脸别碰,尤其别商用。没拿到授权就拿亲友、明星、网图里的脸去生成形象,哪怕老实标注了AI,只要熟人对得上号,照样可能构成侵权,商用场景的赔偿只会更重。第三条线:按规矩亮身份。AI生成内容按规定要加醒目标识,各内容平台也都配了「AI生成」标签,发布时点一下,是义务,不吃亏。
顺带捎一句给开店的朋友:给店铺定制专属AI模特脸,涉及深度合成、可识别性、标识义务一整套更严的账,跟个人玩票完全不是一个量级,那篇有专门讨论(店铺想要专属AI形象,为什么别拿真人照片当底稿),建议照着那条路走。
写到这儿,开头的两个问题都落了地:AI模特图不是「改」出来的,是扩散模型从随机噪点里一步步收敛出来的;同一句提示词出不同的图,是因为起点那把骰子每回都重掷。原理不神秘,边界也清楚——自己的脸自己玩,别人的脸不碰,发布亮明AI身份,三句话够用。
常见问题
AI模特图是拿真人照片修出来的吗?
不是。生成的起点是一整块纯随机噪点,不存在底稿照片,画面是模型按提示词从噪点里逐步「脑补」出来的。模型训练时见过海量图片,但学到的是统计规律,不是把原图存成相册随时调用。
提示词写得很细,为什么出图还是不听话?
提示词只决定去噪的方向,压不住起点噪点的随机性,写得再细也锁不死画面。想稳定复现,把种子固定下来;想精确控制构图,用垫图或局部重绘把随机空间锁小,比堆提示词管用。
用自己照片生成AI模特照,人脸数据安全吗?
肖像权这层没问题,风险在隐私。上传前查三点:平台会不会拿照片训练模型、能不能申请删除、会不会共享给第三方。介意的话选支持本地运行的方案,证件照这类敏感素材尽量别传。
AI模特图能直接用在电商详情页吗?
自己原创生成、不含任何他人可识别形象,加上清晰的AI生成标识,一般可以;拿真人照片(包括自家签约模特的旧照)当素材去生成形象再商用,是肖像权高危动作,商家场景建议走原创虚拟形象的路线。