ai图片生成模特同一个词出三种人?聊聊模型的方言
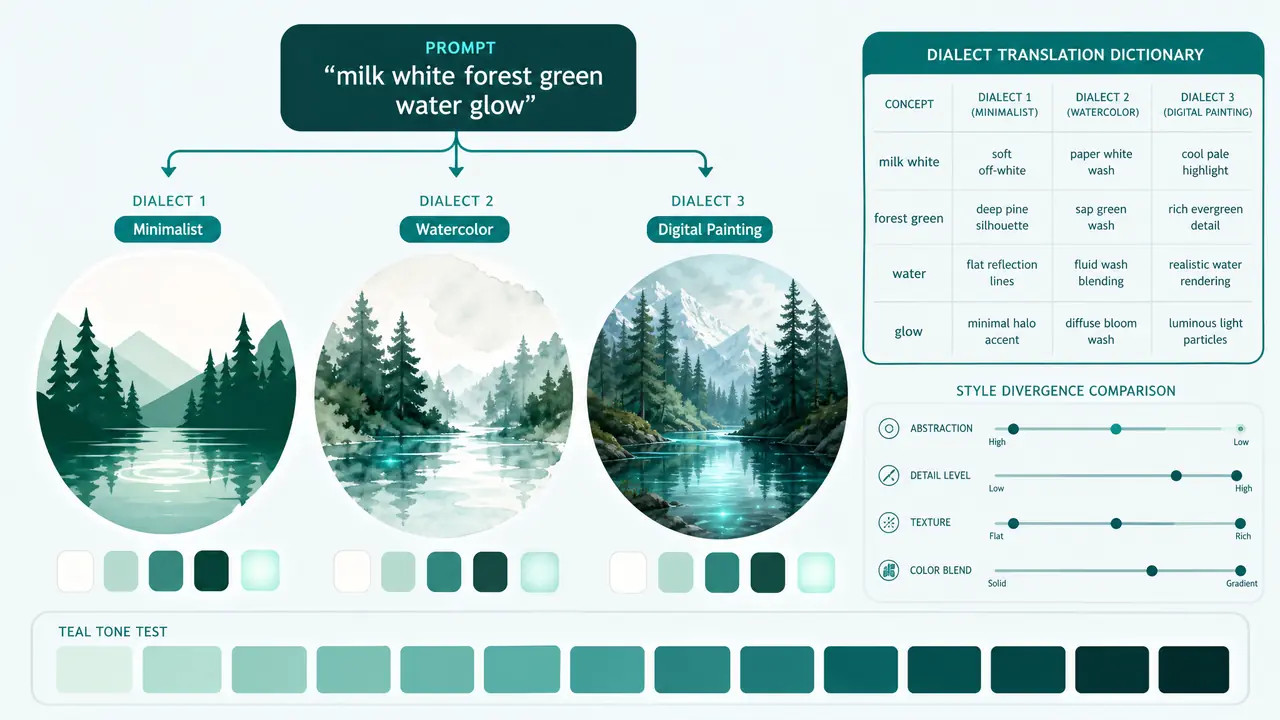
多工具用户说句实话:在ai图片生成模特这件事上,提示词不是通用货币,是方言。同一句"清新风少女",我常年的三家工具跑出来是三种人——日系奶白、森系绿意、韩系水光。词没变,变的是每家模型的"口音"。换工具不改词库,等于拿普通话的调子去念粤语,客户一眼就听出来了。
用ai图片生成模特出图快一年了,我最想告诉新同行的一件事是:同一个词,每家AI理解的都不一样,这叫模型的方言。你词写得再标准,到了别人家的模型里,它也按自己的口音念。所以判断一家工具合不合手,看的不是它出图多好看,是它跟你的词库对不对得上。
同一句"清新风少女",为什么三家出的是三种人
同一句词出三种人,是因为各家训练数据的审美底色不同,不是谁出错了。就像方言,每个模型都是按自己"老家"的语感来理解"清新"这两个字的,出图自然会分岔。
上个月我做过一个小实验,起因是客户让我形容"清新的感觉",我一时词穷,就把手头三家工具拉出来跑同一句词,结果比想象的夸张:日系底子的那家,出的是奶白色调、低饱和、皮肤透着一点粉;欧美训练底子重的那家,直接给绿意盎然的森系,光线像午后树林里漏下来的;韩系数据占优的那家,出的是水光肌、玻璃唇,干净得像刚从精修图里走出来。
三张图都挺好看,问题是它们不是同一种"清新"。我把最常用的几个风格词挨个过了一遍,整理成一张对照表:
| 我输入的风格词 | 日系底子那家 | 欧美底子那家 | 韩系底子那家 |
|---|---|---|---|
| 清新风少女 | 奶白色调、低饱和、胶片感 | 森系绿意、自然光、户外感 | 水光肌、白净、影棚柔光 |
| 元气感 | 微微一笑、腮红、居家场景 | 大笑、运动感、外景逆光 | 甜妹表情、打光精致、妆感明显 |
| 高级感 | 性冷淡灰调、留白多 | 杂志硬光、骨相立体 | 氛围感柔焦、皮肤质感拉满 |
| 慵懒风 | 居家服、自然卷发、晨光 | 复古沙发、暖黄调、卷发凌乱美 | 纯欲系睡衣、冷白皮、室内灯光 |
| 干净背景 | 米白墙面带一点阴影 | 真的给你纯白棚拍 | 渐变灰带反光板痕迹 |
这张表我贴在工位边上快一个月了。有个朋友来我那儿玩,盯着看了半天说了一句特别到位的话:你以为你在写提示词,其实你在做翻译——把你的需求翻译成这家模型听得懂的家乡话。
跑个题,这让我想起刚学剪辑的时候,同一个"转场",Pr、剪映、达芬奇给我的也是三个路数,后来各记了一本账才理顺。工具圈的道理相通,模型只是把差距藏进了你看不见的训练数据里。
十词方言测试:换引擎前,先让它念一遍你的词表
换引擎前必须做十词方言测试:挑十个最常用的风格词,每词单跑四张,半小时出一份差异报告。这一步省不掉,它决定你的词库要不要重写、哪些词要加注解。
具体怎么跑,说下我的固定流程。词表十个词,是从过往三个月的订单里数出来的:清新风、元气感、高级感、慵懒风、纯欲、中性、复古港风、商务感、运动感、胶片感,覆盖了我八成以上的日常出图需求,剩下两成基本是它们的组合变体。
执行节奏:每个词只喂词本身,不带修饰,每家工具各跑四张,取多数倾向记下来。全程二十五到三十分钟,落成一张表,跟我现役工具的表并排放。对比只看三个问题:哪几个词两边理解接近、哪几个词完全分岔、分岔往哪种审美偏。
实测下来一般有三种结果:运气好,十个词里七八个接近,词库微调就能迁移;最常见的,四五个词分岔,这几个词要单独加"翻译注解",比如"清新风"在那家要补"低饱和、胶片颗粒"才压得住默认倾向;最惨的是六个以上对不上,两家审美底色根本不是一个流派,词库基本重写,迁移要重新评估。
顺便提一句,方言测试的词表要定期换代。我三月那版词表里还有"赛博感",六月复测时发现单子里已经没人要这个风格,就换成了"胶片感"。词表是活的,跟着订单走,别一份表用到天荒地老。
翻车实录:没做方言测试,整批"清新"全成了"田园风"
我付过的最贵学费:换工具没重调词库直接批量出图,四十张图的"清新"全跑成"田园风",返工成本翻了一倍多。从那以后,方言测试成了我的固定动作,一步都不省。
九月初接了一个女装店铺的秋装单子,四十张模特图,要求"清新"。当时主力工具排期爆了,我顺手换了另一家口碑不错的工具接活,心想着都是主流工具,一个"清新"能差到哪儿去?词都没改,直接批量跑。
跑完我脸就绿了。那家模型的"清新"是往田园方向理解的:麦田背景、藤编帽、亚麻长裙,画面里恨不得再塞一只柴犬。客户要的是城市里的清爽感,我给交付了一整套"回归大自然"。客户回消息就一句:"你是不是换风格了?"这句问话的杀伤力,比骂我一顿还大。
算笔账你就知道这笔学费多贵。四十张图,每张摊上改词、重跑、筛选大概六分钟,第一轮返工就是四个小时;重跑之后有九张还是偏,又挑词又补跑,再搭三个小时。加上跟客户来回解释,这次返工总共吃掉我一天半,利润薄了一半还多。而一份十词方言测试的成本是半小时。半小时对一天半,这笔账我刻在脑子里了。
现在我的规矩是:主工具换引擎版本、新接一家工具、甚至老工具大更新之后,方言测试重跑一遍,词表同步更新注解。麻烦是麻烦了点,但比起对着四十张田园风图发呆,这点麻烦实在算不上什么。
写到最后,把判断再压缩一下:模型方言不是缺陷,是每家模型的性格。你要做的不是找一个"发音最标准"的工具,是弄清手里每家工具的口音,把词库按口音各备一版。换工具之前,先让模型把你的词表念一遍——半小时的测试,买的是整批图不返工的底气。
常见问题
模型方言会随着模型升级消失吗?
短期看不到头。模型每次升级,默认审美可能会漂移,原来压得住的词可能突然压不住了。所以我把"大版本更新后重跑方言测试"写进了自己的固定流程,升级当周就测,别等客户来当第一个发现的人。
用英文提示词能绕开方言差异吗?
绕不开,只会换一种方言。英文词同样存在同词异解,比如"clean"在有的模型里是极简,在有的模型里是干净背景,分岔的逻辑一样。语言换成英文只是换了个语系,方言现象本身还在。
方言测试多久做一次合适?
我的节奏是三个月一次例行复测,外加三个触发条件立刻补测:主力工具大版本更新、新工具入列、订单风格词出现明显变化。频率不用太高,但触发条件到了千万别拖。
可以直接抄别人公开的方言测试词表吗?
可以当起点,别当终点。别人的词表对应的是别人的订单结构,你的高频词跟他的大概率对不上。抄十词框架,然后按自己最近三个月的订单把词换成你自己的,测试结果才对你有用。