模特摆姿势ai指令怎么写?三层结构加实战命中率拆解
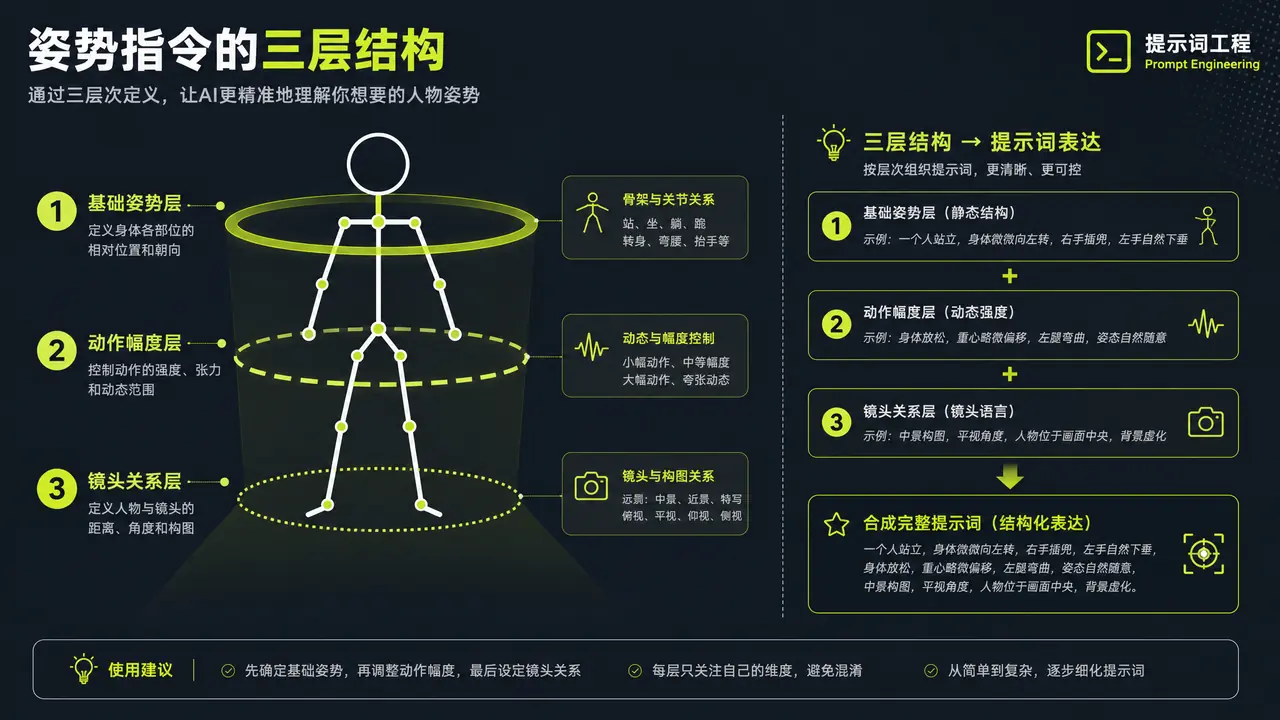
把话挑明:多数姿势废图是指令没分层。基础姿态、动作幅度、镜头关系各管各的,24条老指令按这三层重写后,可用率从38%抬到71%。先拿三层检查你手头的提示词,再谈调参。
模特摆姿势ai指令写得好不好,直接决定一批图里能挑出几张。同一件衣服、同一个模型,姿势指令换个写法,可用率能差出一倍,这事我每个月都在重演。
我手机备忘录里存着一份姿势指令表,攒到现在四百多条,每条后面跟着可用率和一行备注。这表的来历不太体面:去年接一批羽绒服详情图,六十张废了三十八张,废因清一色是姿势——手肘反着折、重心悬空、人和衣服各飘各的。词是没少写,图全废了。从那天起我开始一条条补记,翻车类型到今天基本收敛成下面要说的这几种。
姿势指令拆三层:基础姿态、动作幅度、镜头关系
一条能用的姿势指令由三层叠成:先定身体的基础姿态,再给动作幅度标刻度,最后交代镜头关系。三层各管一摊,缺哪层模型就在哪层自由发挥。
基础姿态回答"身体默认是什么状态":站着、坐着、靠着、蹲着。这层是地基,模型执行得最稳,用词越朴素越好。动作幅度管"在默认状态上动多大":微微侧身、单手轻插兜、45度,都是给动作上标尺。镜头关系最容易被漏,景别、机位、脸朝哪,全归这层管。
拿一次实际的重写说明。原来写的是"模特摆出优雅动感的姿势站在店里",十张废九张,废法五花八门,有一张人直接飘在半空。按三层拆开:基础姿态写"自然站姿,重心落在左腿",动作幅度写"右手轻提包带",镜头关系写"全身入镜,平视"。重跑一轮,废图立刻少了一多半。顺序也有讲究,我固定按姿态、幅度、镜头排,倒过来写模型偶尔顾此失彼。
三层分工一张表说清:
| 层 | 管什么 | 有效词(可直接抄) | 无效词(写了等于白写) |
|---|---|---|---|
| 基础姿态 | 身体的默认状态 | 自然站姿、坐在凳子前三分之一、靠墙站立、单腿微曲 | 自然的姿势、放松地站着、随意一点 |
| 动作幅度 | 动作的大小和方向 | 微微侧身、单手轻插兜、双手交叠、45度 | 动感一点、活力一点、舒展大方 |
| 镜头关系 | 景别、机位、朝向 | 全身照、平视、面向镜头、膝盖以上 | 最佳角度、完美视角 |
无效词那列得多说一句。"自然的姿势""动感一点"这类词的问题在哪?它们没给模型派活。模型收到"动感"两个字,只能去猜是迈步、跳跃还是甩头发,猜对猜错全凭运气。你说它执行力差,它比谁都冤。
有效词与无效词:用480张图换来的名单
2026年10月我挑24条老指令按三层重写,前后各跑240张对照,可用率从38%提到71%。提升大头在幅度层,废图近一半栽在幅度没写。
测试口径交代一下:同一个模型、同一批采样参数,重写前240张(24条各10张),重写后同样240张,废图判定就一条——姿势和描述对不上,或者肢体出问题。归因用小样单独测,每补一层抽8条指令各跑5张。只补基础姿态层,可用率从38%爬到52%;幅度层补上,到65%;镜头关系补完,落在71%。三层里幅度层贡献最大。
有效词这边,姿态层留下的是"自然站姿""坐在凳子前三分之一""靠墙站立,单腿微曲"这几个老面孔,几乎不挑模型。幅度层真正管用的是带刻度的词:微微、轻轻、45度、单手。有刻度,模型才知道劲使多大。镜头关系层的"全身照""平视""膝盖以上"属于硬指令,模型执行得特别老实,写什么给什么。
无效词名单比有效词还值钱。姿态层的"随意一点"、幅度层的"活力一点""舒展大方"、镜头层的"最佳角度",我全部拉黑。最冤的是"优雅",起初我觉得这词挺具体,专门测了一轮:十张里三张手型崩坏,两张脖子拧得不像活人。它看着具体,落到模型那就是一团雾。这类词留在指令里,等于给废图发通行证。
两种典型翻车:幅度写太大,指令和景别打架
最冤的两类废图都坏在指令上:动作幅度超出模型能力,肢体直接崩;动作和景别抢画面,模型只能硬塞。各给一个现场。
第一类,幅度过大肢体崩。上个月出冬装裙的图,我写了句"大幅转身,裙摆飞扬,双臂舒展",连跑十张废八张:三张六指,两张手肘反着折,还有一张胳膊绕到裙子后面出不来。把幅度砍半重写——"身体微微右转,右手轻提裙摆"——十张成八。现在表里记着一条死规矩:动词前面不带"微""轻""一点"这类限字,我默认它要出事。
第二类更隐蔽,指令和景别打架。有回我写"双手交叠放在身前",景别却写了"面部特写"。出来的图,四张在脸颊旁边硬挂了半截手,六张手干脆消失。模型没处放手,又不敢不执行,只能硬塞。从那以后我交指令前多一步自查:动作写到哪个部位,画面里就得有那个部位的容身之处。特写别提手,全身照才轮得到腰腹以下的戏。
两条规律其实是一回事:模特一次只演一场戏。你让它幅度大、景别近、动作多,它处理不过来,就开始发明人体结构。我个人现在的底线是一条指令最多一个大幅度动作,两个以上必废,这条压死了无数次侥幸心理。
姿势库按品类攒,别按动作攒
姿势库建议按服装品类分文件夹,连衣裙、裤装、外套各存各的,同一个动作换品类可用率能差三成。每条记五个字段就够用。
我早期把库按动作分,站姿一页、坐姿一页,用起来才发现不对:连衣裙和裤装的坐姿根本是两回事。连衣裙坐姿十张废六张,裙摆全压出死褶;裤装坐姿十张能成八张,是全库最稳的基本盘。分家之后查找快了,命中率也上来了,因为每条记录只服务一个品类的身材逻辑。
条目字段五个:指令原文、三层拆解、所属品类、可用率、最近验证日期。最后那个日期别省,模型一升级,老记录会悄悄掉率。我固定每两个月拿全库跑一轮复测,掉到六成以下的重写或淘汰,一轮通常有一两条要动。
再给个偷懒的出口:指令实在救不回来的姿势,换条路走,用带骨架控制的工具按骨架摆,三种生成路径的差别我在AI生成模特三条技术路径里对比过。库管姿势,工具兜底,两头不耽误。
回到备忘录里那份四百多条的表。它没什么神秘的,就是每次翻车记一笔,每条指令拆够三层。你要是这周正被废图折磨,先别急着调参数,把手头几条姿势指令按基础姿态、动作幅度、镜头关系过一遍,多半能当场揪出几个空转词。揪出来,删掉,图就稳了一半。
常见问题
姿势指令写中文还是英文更稳?
我两边各跑过整轮对比,命中率差距在五个点以内,比想象中小。真正拉开差距的是写法,不是语言。用哪家中文模型就写中文,硬混英文有时还会触发奇怪的直译姿势。
三层全写下来句子很长,模型会记漏吗?
三层压进一条25到40字的短句就够,不用拆成三句。我库里最长的指令38个字,执行很完整。让模型记漏的从来不是句子长,是形容词堆太多。
想固定一个手部特写的姿势,怎么写成功率高?
手是全身上下最难伺候的部位,我库里手部姿势的平均可用率只有一半上下。写法上给手一个明确落点,"手指轻搭在杯沿"比"手部特写"稳得多,再配局部重绘兜底,救不回来就换手势。
模型升级后,姿势库里的成功率记录还作数吗?
大版本升级后头两周我一律当存疑处理,拿三条最简单的指令各跑五张试水,掉得多就安排全库复测。记录本身不白记,它存的是词和写法的相对强弱,这个趋势大体还在。