AI绘画之模特是什么意思?三层概念一次讲清
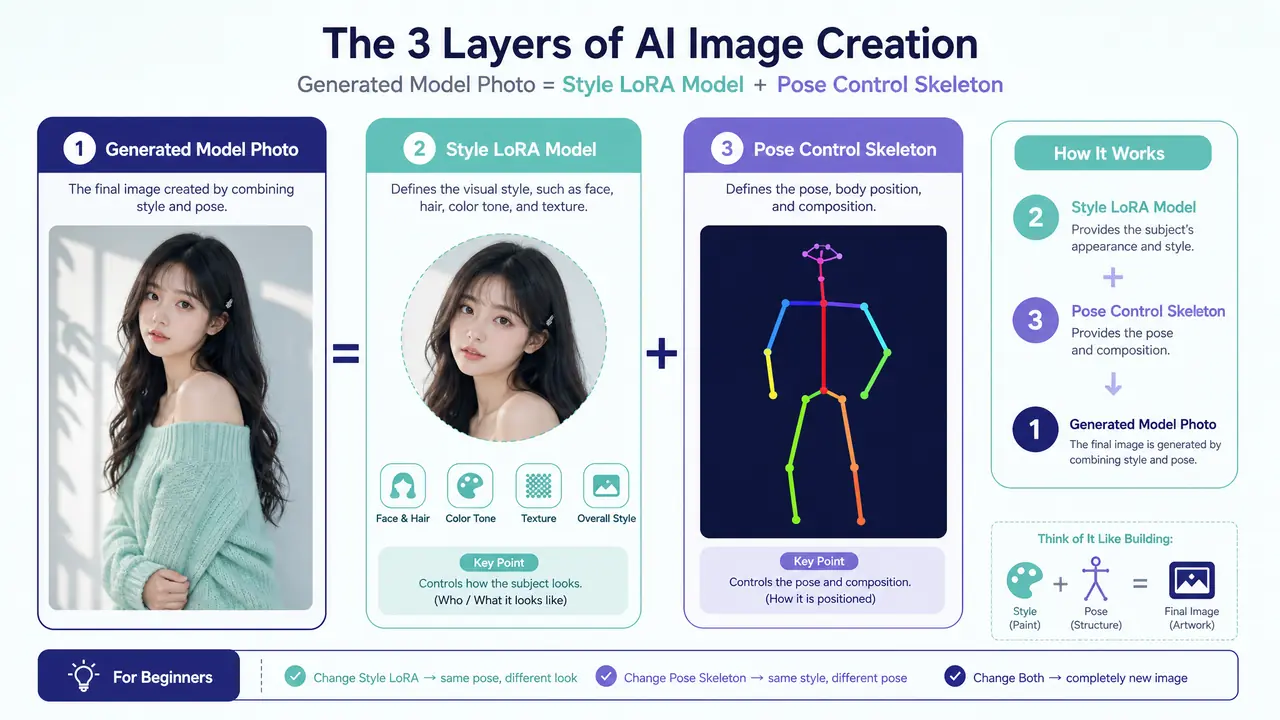
先把地图摊开:AI绘画里的"模特"其实是三个不同的东西——电商用的模特成品图、专练人物形象的LoRA模型、管姿势的骨架控制技术。教程看不懂,多半是这三个概念共用了同一个词。对着下面的表拆一遍,再看任何AI模特内容都能对号入座。
AI绘画之模特,多数时候指的不是同一样东西,而是三层概念的总称:直接生成的模特图、专练人物的模特LoRA、控制姿势的骨架技术。三层各管一摊,混着用就会出怪问题——有人下了个LoRA就坐着等电商成片,等半天发现还得自己写提示词、摆姿势,连问题出在哪都不知道。
这个困惑有多普遍?上个月我们后台收到127条AI绘画相关提问,63条在问模特图怎么出,41条绕着"脸怎么保持一致"打转,剩下23条卡在姿势上。措辞五花八门,归拢完就一句话:这三个词到底是不是一个东西。这篇只干一件事,把它们拆开。
AI绘画里的"模特"到底分哪三层
AI绘画之模特分三层:模特图是成品照片,模特LoRA是固定人物的训练包,模特姿态控制是摆姿势的骨架技术。同一个"模特"字眼,三层指的东西完全不同。
第一层最好懂。你在工具里输入"白底棚拍、亚洲女模特、黑色风衣",几十秒后出的那张图就是模特图。它是一张成品,用完即走,下次再生成多半换张脸。电商换款式、换背景用的就是这层,见效最快。
第二层开始烧脑。模特LoRA是个训练包——喂它二三十张同一个人的图,它就学会"永远长这张脸",之后随便什么场景都能把这个人画出来。打个比方:模特图像每次进照相馆随机分到一个摄影师,LoRA像把某位摄影师签成御用,风格锁死。做虚拟模特IP、固定品牌形象,靠的就是这层。
第三层最容易被略过。姿态控制(常见方案是OpenPose这类骨架)管"人怎么站、手往哪放",原理是先画个火柴人骨架,AI照着骨架填肉,长相和衣服它基本不管。这层我展开少一点——等你要批量换装拍同款姿势时再细究,完全来得及。
| 层次 | 它是什么 | 一句话差别 | 常见用途 | 上手难度 |
|---|---|---|---|---|
| 模特图 | 直接生成的成品照片 | 管出结果 | 电商换款、社媒配图 | 最低,会打字就行 |
| 模特LoRA | 练出来的固定人物模型 | 管脸不变 | 虚拟模特IP、品牌形象 | 中等,要备训练图 |
| 姿态控制 | 骨架定姿势的技术方案 | 管姿势不变 | 同姿势批量换装 | 偏高,常要装插件 |
分层就清楚了。
三层合起来记:模特图管"出结果",LoRA管"脸不变",姿态控制管"姿势不变"。我个人觉得第三层被低估得厉害,很多人在第二层就觉得到头了。
小白最容易搞混的三组概念
最常混的三组:LoRA是训练包不是模特图,模型是画手、工具是画板,姿态骨架只管摆姿势、不管长相。分清这三组,教程起码能看懂一半。
第一组,LoRA不等于模特图。我第一次玩也栽在这儿——下了个人物LoRA,以为点一下就出电商级成片,结果发现还得配底模、写提示词、调参数。LoRA只负责"这个人长什么样",说白了它是配料,不是整桌菜。
第二组,模型不等于工具。底模(checkpoint)相当于画手,你用的平台相当于画板和笔。同一个底模换个平台跑,画风接近但操作差很远;同一个平台换个底模,出图能差出十万八千里。新手总问"哪个软件好",其实该先问"用哪个底模"——那才是决定画面长相的变量。
第三组,骨架不等于成图。有读者用骨架出了图,发现模特换脸了,跑来问是不是工具坏了。不是坏,是这层本来就不管脸。想锁脸,得回头找第二层的LoRA搭着用,两层配合才是完整流程。
三个概念在社区里热度差多少
三个概念的社区热度排序:模特图讨论最多,LoRA训练排中间,姿态控制帖子最少但涨得最快。搜索行为跟这个排序基本对得上。
光讲概念没体感,我数过。2026年10月28日晚,LiblibAI上"电商模特"相关标签下挂着约3400个模型,Civitai的fashion类目下人物LoRA过万;同一晚,两站首页推荐流里姿态控制类内容占比不到十分之一。产出和需求是倒挂的:问模特图的人最多,写深度内容的人却在扎堆研究LoRA。
对了,跑个题——数数字那晚我顺手翻了翻提问区,发现一个规律:问"哪里能直接出图"的,一句话就能打发;问"脸怎么不变"的,得聊训练集;问"姿势怎么复现"的,往往要来回拉扯好几轮。越往下层的概念,问题越黏。话说回来,这不说明第三层不重要,只能说懂的人还少。
后台那127条提问的分布也差不多:大半停在第一层,三成卡在第二层,剩下的一头扎进第三层出不来。三条曲线摆在一起,新手的路径看得清清楚楚——都是先被第一层吸进来,然后在第二层撞墙。
从看懂到动手:按哪条顺序走
顺序建议倒着走:先直接出模特图找感觉,再学姿态控制,最后才碰LoRA训练。上来就练LoRA的新手,大部分会半路弃坑。
第一步,挑个能文生图的工具把模特图跑熟,目标是一周内出一批拿得出手的电商图。具体从哪开始,可以照着这篇AI模特生成操作教程走,从注册到第一张可用图的五步流程都写全了。
第二步,等你不满足于"每次随机一张脸",再去碰姿态控制:装个骨架插件,火柴人摆好动作再生成,同款姿势批量换装就是这么干的。姿势参考怎么用不坑人,这篇专门聊过,动手前建议先看。
LoRA放到第三步。等出现固定的角色需求——比如要立一个虚拟模特IP——再回头研究训练包。到那一步你会发现,前两步攒下的提示词感觉和姿势经验,全都用得上。
回到开头那127条提问。大多数人缺的不是某个神奇工具,而是一张概念地图:知道自己在第几层、缺哪层的能力,再去补哪层的课。下回刷到"AI模特"三个字,先停一秒问自己——它说的是图,是脸,还是姿势?
常见问题
AI绘画的模特是真人吗?
不是。它是模型算出来的虚拟形象,背后并不对应某个真人。也提醒一句:别拿AI形象去冒充特定真人,尤其别拿真人照片去训练或换脸,这类用途在哪个平台都踩红线。
模特LoRA和普通LoRA有什么区别?
原理一样,训练目标不同。普通LoRA可以练画风、练服饰、练某种构图;模特LoRA专练"一个人",训练集是同一个人的多角度照片,目标是锁脸。选的时候看训练集说明就能分辨。
完全不会画画,能做出能用的模特图吗?
能。第一层模特图对绘画基础的要求是零,真正的门槛在提示词和筛选审美上。实际试下来的经验是:新手出的前二十张基本不能用,跑到五十张左右开始稳定出片,这个量绕不过去。
姿态控制一定要装ControlNet吗?
不一定。ControlNet是最常见的骨架方案,但不少在线工具已经把姿势控制做成了内置功能,点几下就能摆。只有本地部署才需要自己装插件,嫌麻烦可以先从在线工具试起。