AI绘画写真原理通俗版:一张图是怎么从噪声里被雕出来的
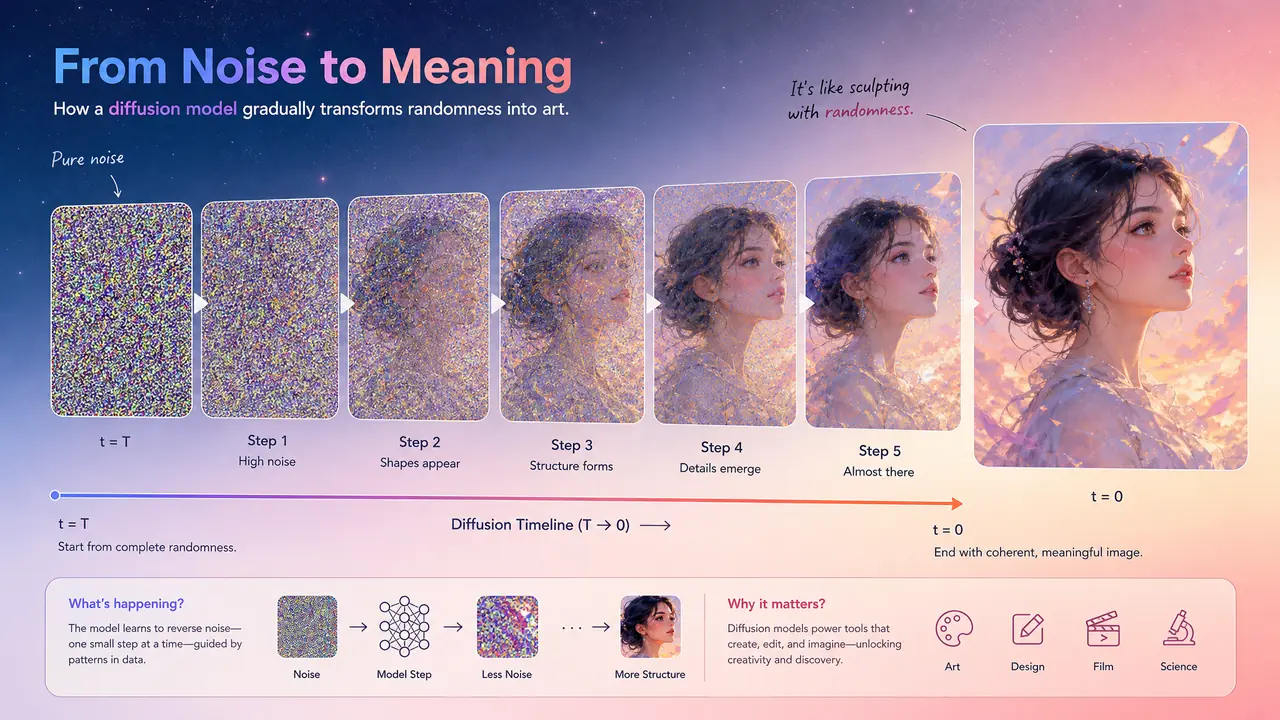
一句话版本:AI画写真不是从图库里挑碎片拼的,它先学过几百万张图共同的长相,出图时从一团纯随机噪声里一步步往回擦。提示词是导航不是画笔,同一句话每次结果不同,因为起点那团噪声是随机摇出来的。
AI绘画写真到底是怎么"画"出来的?这个问题我被圈外朋友问过八次——开奶茶店的同学、做会计的表姐、刚退休的老爸,还有画室开放日凑过来的五个访客。前三次我拿术语讲,什么去噪、什么潜在空间,讲完对方的表情从好奇变成礼貌。后五次换了讲法,五个人里四个当场追着问提示词怎么写,剩下一个追着问"那它算不算偷"。这篇就把后五次那套讲法原样搬过来。
先给我的判断:AI不存图、不拼图,它从噪声里"雕"画。这一句接受下来,后面全是顺理成章的细节。
先拆最要命的误会:AI不是从图库里拼图
AI绘画写真不是挑图拼贴:训练时模型看过几百万张图片和配文,学到的是各种图共同的长相,它的参数里不存任何一张完整原图。这一条想通了,伦理焦虑先少一半。
训练阶段发生的事很朴素。工程师往模型里喂几百万张图,每张配一句文字说明,然后反复玩同一个游戏:把图打回雪花般的杂讯,让模型猜"这团乱码原本更像什么",猜错就调参数,这样过上几百万轮。几百万轮下来,它记住的是规律:皮肤有纹理、天空在画面上方、黄昏偏暖、手指多半五根。全是规律,没有图片。
拿我自己打比方。学画头两年我临过上百张图,今天让我凭空默画一个窗边看书的少女,画得出来,可我脑子里并没有哪张原图的拷贝可翻,能调用的只有构图和光影的规律。模型干的是同一件事,只是它"临"的量是我的一万倍,而且它没有手,规律直接落在参数里。
有名画和电影截图它画得特别像,道理也一样——见得太多,规律背得滚瓜烂熟。你让它复现硬盘里某张具体的照片,做不到,那张照片在参数里压根不存在。图库假设错就错在这:图库是存了再取,模型是把几百万张图压成规律,取无可取。
出图那十几秒,机器到底在忙什么
AI出一张写真分三步:从一团纯随机噪声起步,按学过的规律一步步擦掉噪声,提示词在每一步把方向往你描述的样子上掰。三步走完,雪花屏就换成了人。
起点是一团纯随机噪声,就是老电视没信号时的雪花屏。这一步没有任何画面信息,纯靠摇号,摇出什么样就是什么样。
真正的"画"从第二步开始。模型盯着这团杂讯,只干一件事:猜哪里太噪、底下该藏着什么,然后轻轻修一点。修完再猜,再修。市面工具的默认步数大多在二十到五十之间,每一步改动都很小,像雕刻师傅下凿子,一刀只削一层皮,几十刀之后石纹里才露出人形。你点生成后盯着进度条走的那十几秒,里面就是这几十刀。
提示词在干嘛?导航。每修一步,模型都拿你的文字当参照,把修改方向朝你描述的样子偏一点。你写"夕阳海边的白裙写真",它每一步都往暖色调、海面反光那个方向擦。写得太虚,它就往"人类图里最常见的样子"擦——老手劝你提示词写方向、别写成许愿池,道理就在这。
那为什么同一句话每次出图都不一样?起点随机。两团不同的雪花屏,一路擦出来的终点自然不同,同一张设计图纸交到两块纹理不同的大理石上,凿出来的人像也不会逐像素重合。我拿同一组提示词连roll过十次,人物脸型能看出明显差别的有六七次。想把同一张脸摁住是另一门手艺——锁种子、垫图、练卡,我写过专门的实测:LoRA怎么影响AI绘画模特的脸。
三个流传最广的误会,摆一张表里说透
误会共三个:AI不是拼图库,AI不懂美,模型越新也未必越听提示词的话。前两个讲完原理自破,第三个最反直觉,单独说。
| 流传的说法 | 真相 | 对你出图的实际影响 |
|---|---|---|
| AI从图库里挑碎片拼图 | 参数里没有原图,只有压缩后的规律 | 找不到"它抄了哪张",风格像是因为学得多 |
| AI懂美,审美超过人类 | 它复现人类图里高频出现的构图配色,不做美的判断 | 十张里挑两三张的活儿还得你干 |
| 模型越聪明越听提示词 | 新版更会读长句,可自有主张也更重,爱把怪点子往"正常"掰 | 写方向比堆形容词管用,怪组合得靠图生图硬带 |
第二条我多聊两句,它最容易骗到人。模型出的是"人类审美的平均值",平均水平稳,惊喜没有。我出十张街拍构图的写真,能直接交稿的常驻两三张,剩下七八张是那种说不出哪里不对、就是平的图。挑图这一步省不掉,工具再新也省不掉——好图是挑出来的,这句是我带新手时说得最多的一句。
第三条我有现成的对照。同一句怪提示词"逆光的鱼在天上飞",旧版模型老实画了条鱼悬在半空,新版多给我加了飘动的水痕和一整条河——它见过太多正常图,会把离谱组合往它认为合理的方向修。句子理解能力上新版确实进步不小,服从性反而松了。聪明和听话是两码事,这是我用下来最真实的一条感受。
回到表姐那个问题。这套比喻讲完,她没再提图库,末了冒出一句:所以它像是个把全世界的画都临过一遍、手上没准头、你说往哪凿它就往哪凿的学徒?我说对,就是这话。原理讲明白了就一句话的事,讲不明白才需要术语。下次再有人问你AI绘画写真是怎么画出来的,把雪花屏和雕刻这两个词甩过去,够了。
常见问题
AI绘画写真同一句话能生成两张完全一样的图吗?
默认不能。起点噪声每次随机摇,一路擦的终点就不同。想复现要锁种子,就是工具里叫seed或随机种子的那串数字,同样的种子配同样的提示词和步数,出来的图才会逐像素一致。
为什么AI画手指经常翻车?
手在训练图里常年以握东西、被遮挡、运动模糊的形态出现,五指摊开正对镜头的干净样本占比小,这块规律学得不扎实。新版模型好了不少,手指交叠的角度一多照样崩,出完图先看手再看脸。
训练图里没出现过的人,AI凭什么也能画出来?
凭规律。它不检索某个具体的人,而是把人类长相拆成五官比例、肤色分布这些规律,再按提示词重新组合。画出来的陌生人总觉得眼熟,是平均脸效应,不是它认识这人。
提示词是不是写得越长越细越好?
不是。接着用导航的比喻:路标太多,模型会在半路抢方向。我的习惯是主体、风格、光线三段,几十个词收住,细节出完图看哪里缺再逐轮补。
延伸阅读
- AI绘画写真教学第一课:零基础90分钟从注册到出第一张图——原理懂了就该上手,这篇掐着表把第一张图的流程走完。
- AI生成模特三条技术路径的底层区别:凭描述画、照着改、按骨架摆——把"从噪声擦图"这一条原理延伸成三种实际玩法。