AI动画AI绘画联动手记:静图要提前给动起来留余地
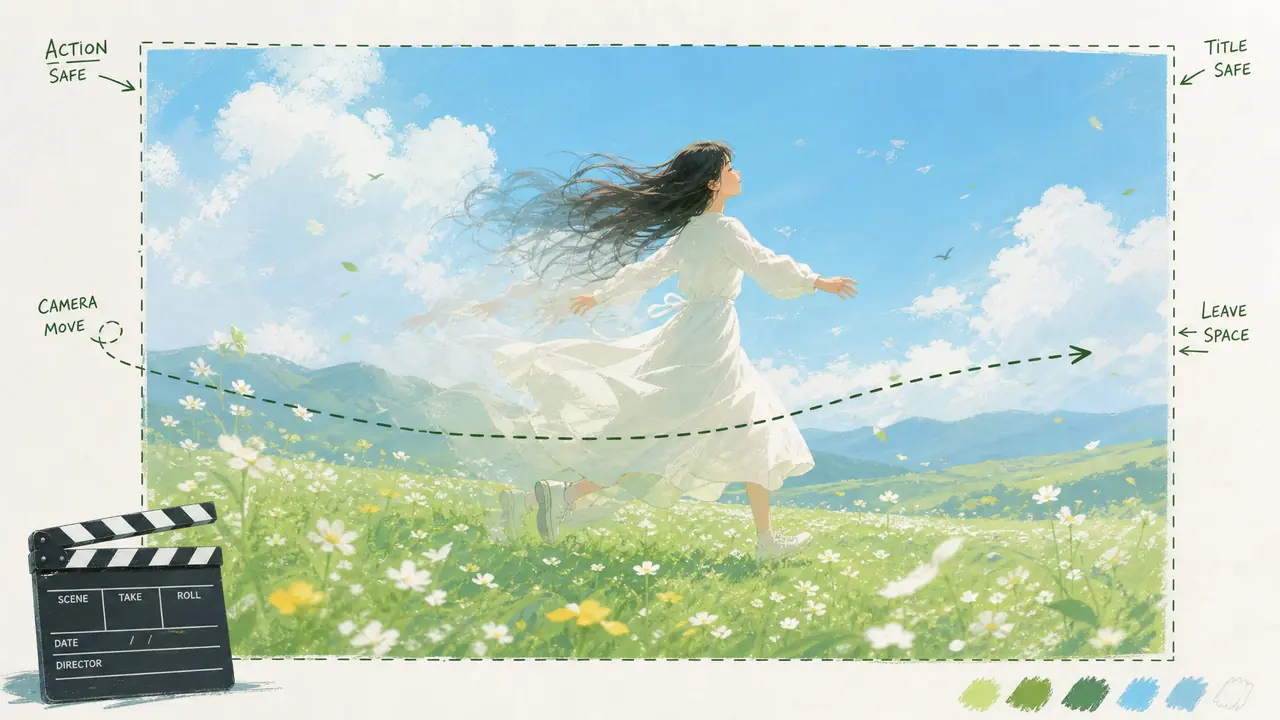
静图画得越满,动起来越容易崩。我的判断是:AI动画AI绘画联动的关键不在动画那一步,而在静图就要给运动留缝。建议你先对照下面的翻车记录自查首帧,再谈参数。
上周我把攒了半个月的十几张图丢进图生视频,想着顺手剪个小动画发群里。结果第一段出来,角色的脸就跟被门夹过一样,第二段直接手臂穿墙。老实讲,我当时第一反应是工具不行,后来重看了三遍首帧才发现,问题一半出在我自己那张"太完美"的静图上。AI动画和AI绘画看着是一条流水线的上下游,中间其实隔着一道思维方式的坎,这道坎不跨过去,参数调到天亮也白搭。
静图和动画图到底差在哪
静图追求单帧信息量拉满,动画图只求关键帧信息够用,剩下的部分交给运动去补。这句话听着抽象,落到画面上就是三个具体的取舍。
打个比方,静图像拍证件照,构图、光线、发丝全都焊死在一个瞬间;动画更像跟拍的纪录片,允许糊、允许轮廓松,因为十二分之一秒根本没人看清你袖口的花纹。我做过一个笨对比:同一角色的背影,A版本把裙摆褶皱画了二十多条,B版本故意只留三五条大褶,别的地方不动,拿去各生成一段。A动起来满屏碎线抽搐,B反而顺滑。那次之后我改了出图习惯,给"可能会用动画"的图留三成细节余量,宁可素一点。
还有一层是构图密度。静图我喜欢塞前景、中景、背景三层,看起来耐看。可一旦动起来,三层各动各的,第一帧还挺好看,第四帧就开始互相打架。所以现在凡是打算动的图,我最多给两层,背景干脆虚掉,反正没人盯着看。时间尺度也得换算:静图是给人端详的,一张能看半分钟;动画一秒十二帧,没人来得及品细节,信息给八成就够,多出来的全是崩坏风险。
为什么静图很美,一动就崩
大多数崩坏不是模型不行,是静图把运动空间提前画死了,模型只能硬掰。我自己踩过的坑归成三类,都能在首帧里提前看出来。
第一类是人物贴边。首帧里手臂已经顶到画面右缘,视频工具想让手挥出去,只能把手臂折进墙里,穿模就从这里来。第二类是天生要动的东西被画成了雕塑姿态——裙摆收得死死的、长发一根不飘,模型一补间就不知道该往哪儿放,开始左右抽。第三类是光源太绝对,静图里打硬侧光确实出戏剧感,可一到第二帧影子转不动,整段画面就明一下暗一下,像接触不良的灯管。
判断方法土但管用:出图后盯着画面问一句,这张图里的东西,哪个部位"欠着一个动作"?欠得越多的图,动起来越安全。完全自洽、毫无未完成感的图,反而最难伺候。我后来养成了个怪习惯,好图先存着别急着发,扔进视频工具跑两秒试试,扛得住运动再算成品,扛不住的回炉改首帧。这一步一天也就多花十分钟,省下的返工时间按小时算。
我的三次翻车和最后跑通的参数
三次翻车分别是手部裂开、镜头乱飘、光影跳变,最后靠改首帧加收敛参数才压住。参数不神,胜在能复现,你可以直接抄。
翻车一,手指在第四帧裂成六根,重来两回都一样。最后不是换词解决的,是回改首帧,把张开的手掌改成半握,动作幅度小了,崩的概率跟着掉。翻车二,镜头乱飘,把运镜强度从默认砍到3,稳是稳了但画面开始发呆,来回试了几档,落在5。翻车三最隐蔽,光影每两帧闪一次,我起初怀疑是帧率,换了24帧更糟,最后重画首帧,把硬侧光换成柔顶光才彻底止住。
现在跑通的一组是:首帧人物离画面边缘留白约15%,衣摆留"半收拢"的姿态,运动强度0.55,12帧而不是24帧——便宜、稳、返工少。不夸张地说,这套流程让我一次过的概率从三成提到了七成往上,省下的时间够多画五张静图。
回头再看那批崩掉的图,其实没白崩。静图和动画不是谁高谁低,是两套验收标准:静图只需要骗眼睛一次,动画要连着骗眼睛一秒钟。所以下次出图之前,先想好它动起来是什么样,把缝留出来,后面能省一半的折腾。群里那些问我"为什么你的图一动就稳"的朋友,看完首帧基本都沉默了——功夫真的不在动画那一步。
常见问题
不学分镜,光靠提示词能出动画感的静图吗?
能出"感觉上会动"的静图,比如加速度线、飘起的衣角、扬起的尘土,但真拿去当首帧照样容易崩。提示词管的是氛围,管不了运动空间的预留,这活儿只能回到画面里手动改。
图生视频一段做几秒合适?
两到四秒。超过五秒,镜头漂移和光影误差会累积到藏不住,除非你按分镜切成多段再剪,不然单段别贪长。
竖屏和横屏,哪个更容易动稳?
我的经验是竖屏略稳,人物居中时上下方向的缓冲空间大。横屏想稳,左右留白要给得更足,尤其手部动作多的构图,两侧至少各留一成人身宽度。
免费工具能跑这套流程吗?
能,思路完全通用,只是参数上限不同。免费档运动强度选项少,就更得靠首帧本身留缝,首帧改好了,工具之间的差异比想象中小。