身份ai绘画实战:一张脸换三种职业,身份感是怎么穿在身上的
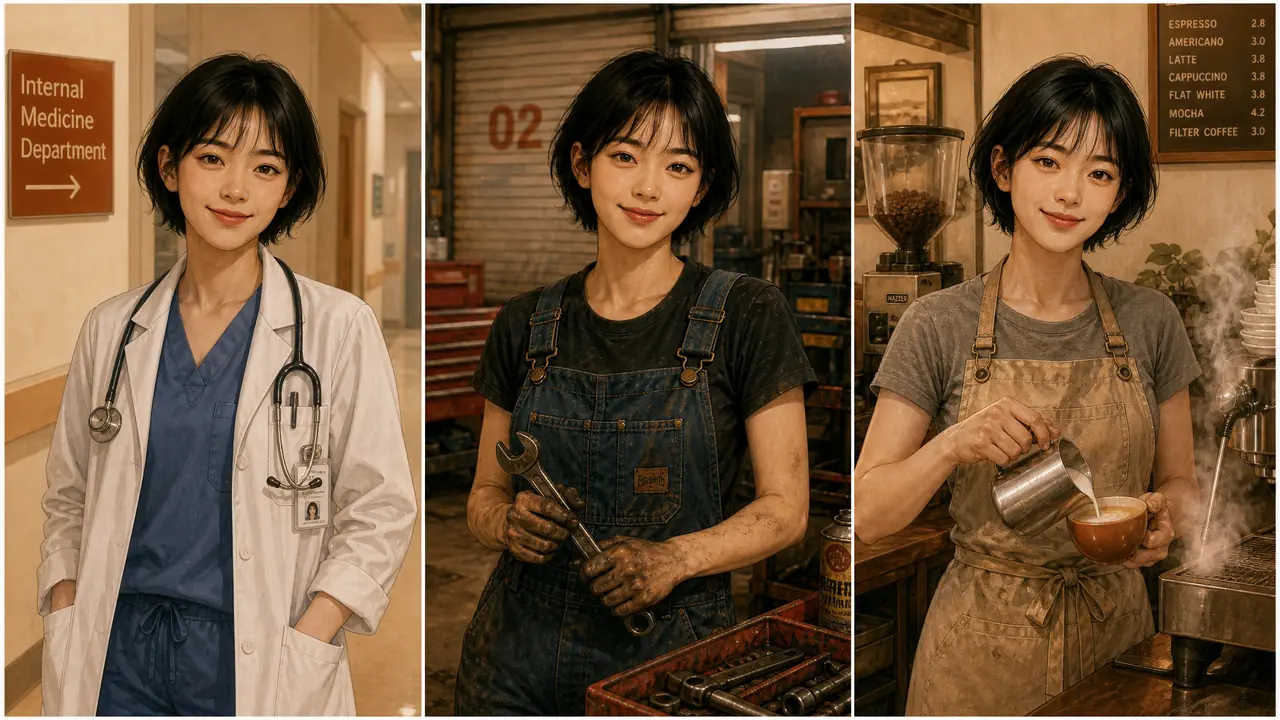
先换三套衣,再谈身份ai绘画能不能出职业感:同一张虚构的脸,光套一件职业装远远不够,道具和环境至少占一半的辨识度。我的依据是同一组参数跑了六次对照,只换衣服的那三张,十二个朋友里只有三个猜对职业。你要先做的事很简单——把三件套装备单列出来,再按顺序喂给模型。
身份ai绘画里最难的不是把脸画好看,是让人一眼认出"这人是干哪行的"。我拿虚拟人物"小满"做了个实验:固定同一张脸,分别生成白大褂医生、工装师傅、咖啡师三个版本。第一轮我只改了服装词,结果白大褂那张被认成实验员,围裙那张被认成超市促销员。脸没变,衣服换了,职业感还是散的。
问题出在哪?后来我把每张图拆成三块来看——穿什么、手里有什么、站在哪。单独换第一块,信息量根本撑不起来。就像你在家里穿泳衣不叫游泳,站在泳池边才算数。职业身份感是个场景判断,不是一个衣物判断。
为什么只换衣服,职业感还是出不来?
衣服只提供约三分之一的识别信息,道具补上"正在干活"的动作证据,环境负责解释这件事发生在哪,三者缺一,观者的第一眼猜测就会跑偏。我的对照组做得很粗暴:同一位虚构姑娘,第一组只写"白大褂",第二组写"白大褂加听诊器加诊室走廊"。发给十二个朋友猜职业,第一组命中三人,两个猜的是药剂师;第二组命中十一人,剩下那个说"可能是兽医"——也算半个医生体系。差距不在画得像不像,在证据链全不全。
还有一个反直觉的发现:道具的位置比道具本身更要命。听诊器挂在脖子上,是"刚用完";攥在手里贴着胸口,是"正在用"。后者那张,连我那个分不清科目的朋友都秒答"医生"。所以我后来固定了一个写法——道具动词化,让每样东西都在做动作。
顺带一提,服装内部的层次也会抢戏。有次我给小满加了条围巾想丰富画面,猜职业的准确率立刻掉下来,有人答"大学生"。画面里每多一件跟职业无关的衣物,身份感就被稀释一分。这个逻辑跟角色塑造是通的——之前写过一篇城主ai绘画(城主ai绘画),那位虚构城主的气场也是靠披风、权杖、高背椅三样东西一起撑着,单给一件就不成立。
服装、道具、环境三件套,各自管什么
服装定行业大类,道具定具体工种和工作状态,环境定真实性与年代感——三件套按这个分工去写提示词,职业识别基本不会跑偏。下面这张表是我给小满三套身份列的装备单,也是我目前用得最顺的模板。
| 要素 | 白大褂医生版 | 工装师傅版 | 咖啡师版 |
|---|---|---|---|
| 服装 | 白大褂敞怀穿,内搭浅蓝刷手服,袖口卷一折 | 做旧深蓝工装外套,胸口有油渍印,袖子挽到手肘 | 褪色卡其布围裙,斜挎半截,内搭灰T恤 |
| 道具 | 听诊器贴在胸口,另一手夹着病历板 | 右手握活动扳手,指缝有机油痕 | 正往拉花缸里倒奶,手腕悬着 |
| 环境 | 诊室走廊,墙上有科室牌,顶灯偏冷白 | 修车铺卷帘门半开,地上摊着零件盘 | 吧台后,蒸汽棒冒着白汽,背景是磨豆机 |
三个版本我都压着一个原则:每套只留一个主色调环境的干扰物都清掉。医生版背景我只允许"走廊、科室牌、灯",多写了CT机,准确率反而降——观者会开始琢磨"这是不是放射科",注意力就偏了。
同一张脸改三种职业,我的实操顺序
先锁脸再换装,三件套按"服装加权重、道具动词化、环境给一两个锚点"的顺序填进去,最后留一轮专门删杂物,整个流程四次出图内能定稿。我的固定步骤是这样的。
第一步锁脸。用同一组面部描述词原封不动地复制到三个提示词里,参数也钉死:采样步数28,CFG6.5,尺寸896x1152。脸是变量控制的基准,动什么都不能动它。
第二步给服装加权重。白大褂那次我写成"(white lab coat:1.2)",敞怀、内搭、袖口这些细节跟在后面。权重别拉太高,1.3以上衣服会糊到脸上,我翻过这个车——小满的脸直接被领子吃掉半边下巴。
第三步道具动词化。"holding a stethoscope against her chest"比"a stethoscope"出图准得多。第四步环境给锚点,一到两个就够,科室牌、蒸汽棒这种带文字感或动态感的东西最好用。
最后一步专门用来做减法。我管它叫"清场":把跟职业无关的饰品、背景人物、多余光源全部删掉再跑一轮。三次清场下来,三套图的职业识别都能稳定在十一个人以上猜对。这套流程其实就是给画面做证词——每件东西都在替"她是干这行的"作证,证词越齐,观者越不犹豫。
回到开头那个实验。小满还是那张脸,三套衣一换,连表情都跟着变了:医生版她眼神是平视的,师傅版微微皱眉,咖啡师版嘴角带笑。职业身份感从来不只长在衣服上,它长在整张图的信息密度里。下次出图前,先别急着写脸,先把三件套的装备单列完——清单齐了,图就成了一半。
常见问题
三件套写进提示词会不会太长,导致模型顾此失彼?
会,所以我控制在三十个内容词以内,超出就删环境里的次要物。实测服装词加权重后,模型对服装的执行最稳,环境和道具各给一两个强锚点就够,不必铺满。
想换的是男性师傅这类粗犷身份,脸部描述要不要跟着改?
脸可以完全不动,改的是皮肤质感和手部:工装版我会补"指节粗、指甲缝有灰",职业感立刻实。这是手脚上的戏,不是五官的戏。
环境和道具冲突时,比如医生站在修车铺,会怎样?
模型会老实画,但观者会懵。我的十二人测试里有一张故意做的冲突图,八个人回答"不清楚",两人答" cosplay"。冲突直接清零身份感,别这么干。
同一套三件套模板能复用到别的行业吗?
能,骨架不变,换装备单就行。比如教师版:主衣是针织开衫,道具是举着粉笔的手,环境是黑板加讲台边角。先填表再写词,比凭感觉堆词快得多。