用AI绘画挑战AI:让它画自己,它交出来的答案挺像样
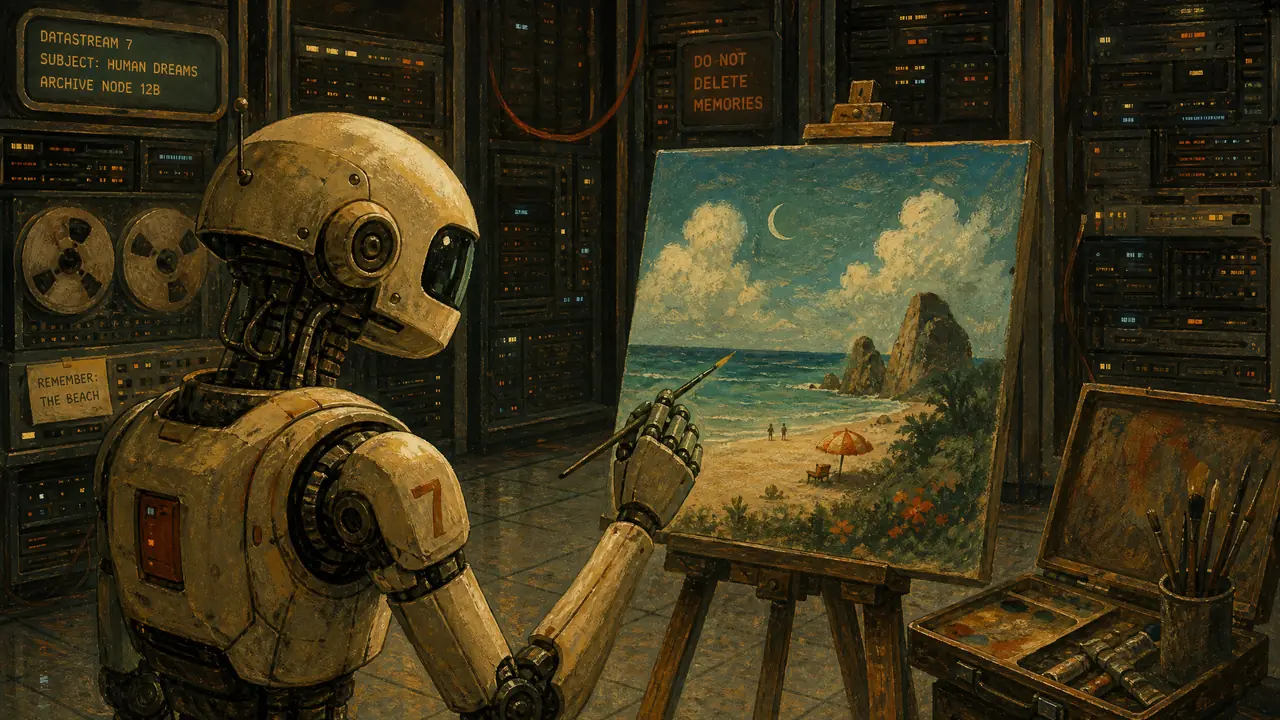
我的判断是:让AI画自己,是检验绘画模型想象力的一块好试纸。四款模型同题跑完四十二张,套路化程度超出我的预期——机械臂、发光大脑、蓝色电路三件套满天飞,反倒是意外崩坏的图最有看头。
用AI绘画挑战AI这个念头,来自一个特别简单的疑问:绘画模型天天被人画,它自己眼里的AI长什么样?训练数据里塞满了人类想象的机器人,那它画"自己"的时候,是复述人类的想象,还是能长出自己的自我认知?
我选了四款手头常开的绘画工具,给同一个题干:"AI在画画"。每款跑十到十二张,一共四十二张有效图。跑完花了一个晚上,看图看到眼花,但挺值得——这批图比任何评测文章都直观地暴露了模型的底细。
四款模型同题,答案惊人地一致
四款模型画"AI在画画",主体几乎都是机械臂持笔,配色高度趋同,蓝色系占了七成以上。训练语料里人类对AI的想象,反过来框死了模型自己的自画像。
四十二张里,十九张是机械臂握画笔或喷枪,八张是发光的大脑或悬浮的芯片人,剩下的比较杂。配色上更夸张:蓝紫色调占了大半,仿佛AI住在同一个色卡里。我专门数过,暖色调只有六张,其中三张还是我提示词里硬塞了"夕阳"才出来的。
最好玩的是细节:好多图里的画布上画的是电路板图案,或者画布里的画布——模型似乎默认"AI画的东西=科技感的东西"。有一张图,机器人在画一个正在画画的更小机器人,画布里还有更小的,无限套娃套了四层才糊掉。这张我存了,当壁纸都行。
同一道题,四款工具的画风差异倒是清晰:有的走厚涂插画,机械臂上有反光高光,质感最扎实;有的偏扁平,颜色干净但像科技公司的官网配图;还有一款特别爱加背景杂乱的机房,十张里有七张背景是服务器机柜。
第二道题暴露了短板:画"AI的内心"
抽象自指题是绘画模型的集体弱项,"AI的梦""AI的孤独"这类题出图套路化严重,几乎全靠符号堆砌。想要有想法的图,得把抽象词翻译成具体场景。
我先用了"AI的梦"这个题,结果二十张图里,梦全是蓝色的云、代码雨和悬浮齿轮,跟百度图片搜"未来科技"出来的结果高度重合。没有一张让我觉得"它做了个梦",全是"它被要求表现科技感"。
后来我换了个笨办法:不写"AI的梦",改写具体场面——"深夜空机房里,一台亮着屏幕的服务器,屏幕上显示一片沙滩"。出来的图立刻有了叙事感,空荡的机柜和一小块沙滩的反差,比一百个齿轮都戳人。这道题的最优解出现在第八张,我后来把它发在朋友圈,配文是"它梦见海了",收了几十个赞。
这事给我的启发挺大:模型不是没有想象力,是人类给它的词太抽象时,它只能退回训练数据的平均值。你把抽象拆成可画的画面,它马上支棱起来。后来的题我全都按这个思路出,废图率肉眼可见地降了。
想玩同款实验,三个坑提前说
自指实验要控制变量、留存原图编号、避开画中画构图,这三点决定你的实验结果能不能复盘。图一多,没编号的对比等于白跑。
第一个坑是不留批次记录。我第一轮就吃亏了,四款工具混在一个文件夹,回头想对比谁出的哪张,全乱。后来每款建一个前缀,编号记到表格里,复盘快了十倍不止。
第二个坑是画中画。递归构图看着炫,实际崩坏率极高,我测下来十张里七八张套到第二层就开始糊,层数越深手指和画框越乱。想要套娃效果,建议只留两层,别贪。
第三个坑是拿这类实验图去冒充"AI的自我意识"发帖博眼球。图就是图,是模型对训练数据的统计复述,把它当谈资可以,当"AI觉醒的证据"就是自己骗自己了。围观可以起哄,下结论要谨慎。
实验跑完,四十二张图翻来翻去,我最喜欢的那张空机房沙滩图,恰恰是提示词写得最不像"AI"的一张。模型对"自己"的想象是被人类的想象喂出来的,你想看新鲜东西,得先喂它新鲜的词。这道题,人类还是占上风的。
常见问题
这个实验需要会写复杂提示词吗?
不需要。我的题干就一句话,重点在控制变量和批量对比,不在单张的精雕细琢。新手完全可以照着跑一轮。
用哪几款工具做这个实验比较好?
手头有什么用什么,关键是选画风差异大的两三款,全是同类工具的话对比意义不大。免费额度就够跑几十张。
为什么AI画自己总是机械臂和蓝色?
训练数据里人类就是这么画AI的,模型学的是这个统计规律。想突破得主动喂反差词,比如暖色、居家场景、抽象场面。
这类实验图发布时要注意什么?
按平台要求标注AI生成,别配上"AI真的觉醒了"这类误导性文案。当趣味实验分享没问题,编故事就变味了。