AI绘画AI动画形成全流程:一张静图到会动要走五步
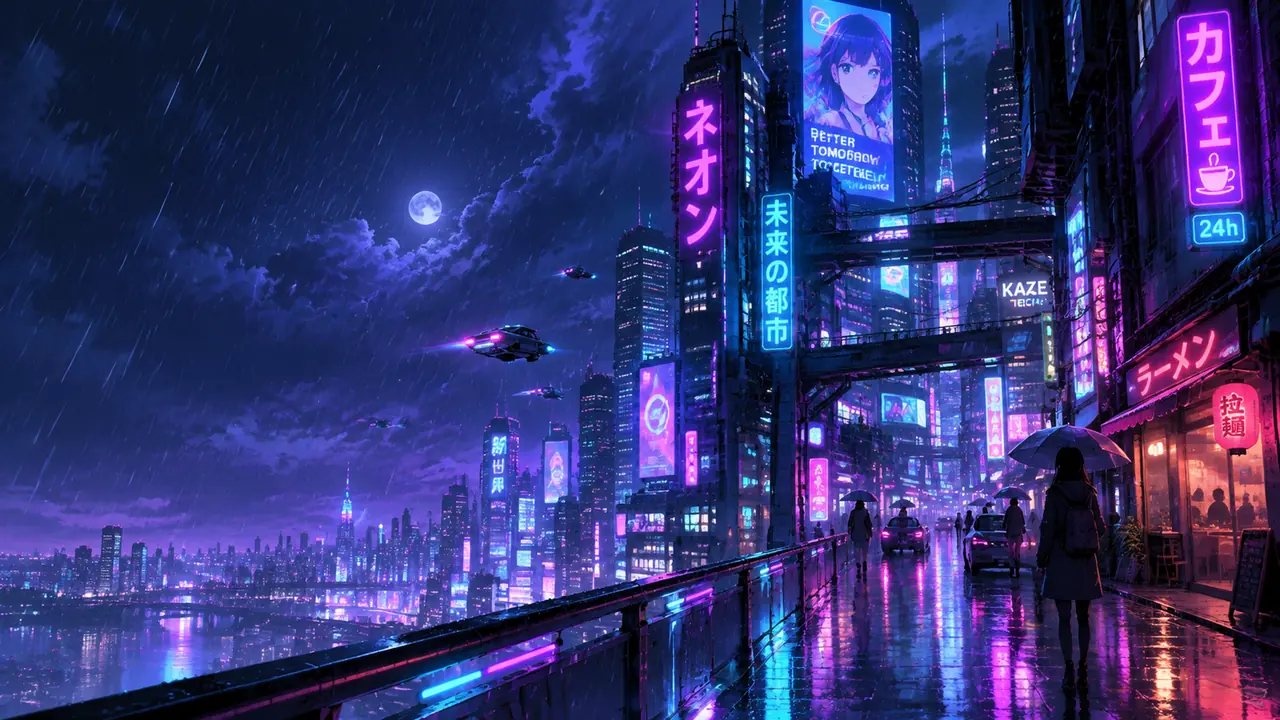
别绕了:AI绘画到AI动画就是五步,定稿静图、留运动空间、写运镜词、图生视频、抽帧筛废。我实测一张街景图,十三次抽卡成了三张,命门在静图阶段的构图。想少废卡,先把图给动画留后路。
AI绘画AI动画形成的完整流程,说穿了就五步,但每一步都有各自的死法。我用一张赛博街景静图完整走了一遍,从绘画到能看的五秒成片,前后折腾了三个晚上。结论先放这儿:动画成不成,七成看静图怎么画,三成才轮到运镜词。
很多人卡在哪?把静图随便丢进图生视频,然后开始骂模型。顺序反了。动画是在绘画阶段就注定的,生成只是把它演出来。
静图阶段就要给动画留后路
想动的图,画的时候就得留出运动空间:主体别顶满画框,画面里放一两个本来就该动的东西。塞满细节的图,动画模型没有发挥余地,只能乱动。
我踩的第一个坑就在这。第一版街景图画得特别满,行人、飞车、霓虹招牌、蒸汽管道全塞进去了,构图没留白,看着信息量爆炸。丢进可灵之后它懵了——每个元素都想动,每个都动得不对,行人飘移,飞车穿模,五秒看下来像一场小型事故现场。
第二版学乖了:构图往下压,上方留出三分之一的天空,只保留两个"天然该动"的元素——闪烁的霓虹灯和飘的雨。同一套运镜词,这版第一次抽卡就出了能看的画面。差别不在模型,在图本身。
人物为主的图同理。半身特写想加镜头推进,人物四周就得留白,脸要是顶到画框边,一推近就是大特写糊脸,五官经不起看。我现在给要动的图定了个自查口令:主体占画面不超过一半,能动的元素一到两个,画框四周各留一口气。
运镜词怎么写才不乱动
运镜词一次只给一个镜头动作,最多再配一个场景内的微小动态,写多了必然乱。"镜头缓慢推进+霓虹灯闪烁"是安全的,再加人物走动就开始崩。
我做过一组对比,同一张图写三种运镜词。A版只写"固定机位,霓虹灯轻微闪烁",十三次抽卡成片率最高;B版写"镜头缓慢推进,雨落下",成功率掉一半,但出来的画面确实有电影味;C版贪心,镜头推进、雨、行人、飞车全写上,十次全废,人物的手和脸必崩一个。
还有个细节:镜头别给太快。"快速环绕"这个词我试了五次,五次全部把街景甩成抽象画。动画模型对慢速运动的处理远好于快速,想要气场就靠构图和光影,别指望它转得动。
十三次抽卡换三秒成片
图生视频目前的现实成本是:五秒成片、单次生成两到三分钟、成功率三成上下。预算按十次抽卡起步,别指望一次过。
可灵一次五秒视频的生成等待在两到三分钟,我那晚连抽十三次,能用的三张,成本算下来一个多小时换三秒。中间最气的一次:前面四秒都完美,最后一秒人物脸突然糊掉,像信号不好的电视台。这种"最后一下崩"在抽卡里出现率不低,现在我的习惯是成片后逐帧过一遍,专盯最后一秒。
抽出来的片子还差一道工序:配音效或者干脆配静帧字幕。五秒的无声画面放进短视频里很突兀,加一层环境音(雨声、车流声),完播观感立刻不一样。
文件规格也顺手记一下:导出选1080P够用,发竖屏平台记得在剪映里二次裁切,别指望模型直接出竖版——横图硬裁竖图,九成会把人脸裁掉一半。
整图动和局部动,先想好要哪种
静图做动画有两条路:整图交给模型自由发挥,或者用运动笔刷只圈出该动的局部。做循环背景选局部动,稳得多;做运镜短片才走整图那条路。
即梦这类工具的运动笔刷我后来用得很勤:把霓虹灯招牌圈出来标记闪烁,雨圈出来标记下落,其余区域锁死。这样出的五秒循环特别适合当视频背景,抽两次卡基本能定稿,比整图动省十倍时间。
代价是画面不会有运镜,永远是固定机位。我给奶茶店朋友做的门口大屏背景用的就是这套,老板只要雨能下、灯能闪,别的一概不关心,五分钟交活。
三个晚上下来,我对"AI动画"这件事的看法变了不少:它不是绘画的升级版,是另一个工种。绘画管住静的部分,你得替它想好动的部分去哪、怎么动、动多快。流程记住了,五步就是台阶;记不住,就是十三次抽卡的学费。
常见问题
没有绘画基础能走通这五步吗?
能。五步里没有一步要求你会画画,最难的是构图判断,这个靠多看多抽也能攒出手感。我的建议是第一周只练固定机位加单一动态,先把成功率跑起来。
图生视频和逐帧动画选哪个?
要氛围和运镜选图生视频,要动作精确选逐帧。图生视频控制不了具体动作,逐帧工程量大但每帧可控,看你的需求偏向哪头。
为什么我的成片总有轻微抖动?
大概率是静图里细节太碎,比如密密麻麻的文字、细网格。这些元素在动画里会各自微动,整体看起来就是抖。简化细节能明显改善。
五秒不够用怎么办?
分镜解决。把一个长镜头拆成两三个五秒片段,分别生成后剪辑拼接,比让模型硬生成十秒稳得多。