对酒当歌ai绘画怎么出味:把诗拆成画面的关键词实测
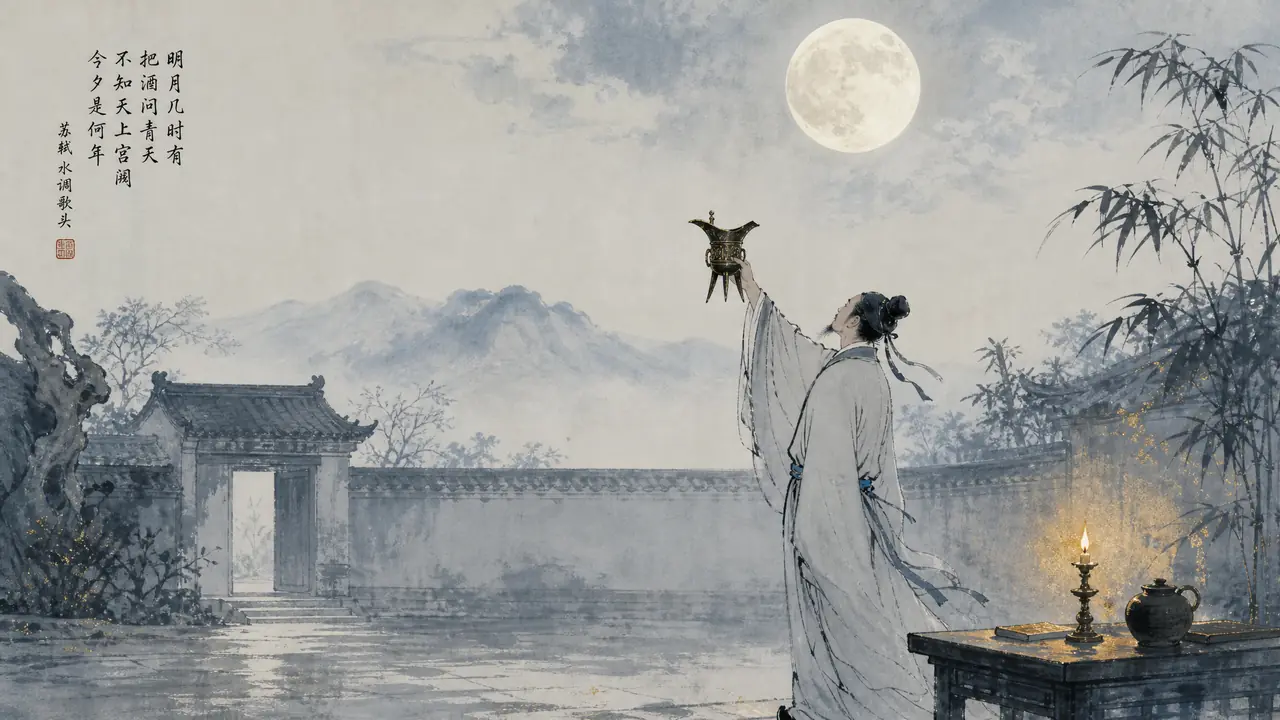
一句话版本:对酒当歌ai绘画想出味,别把这四个字原样喂进去,拆成人物、酒器、月色、情绪四层再喂,成片的古意立刻不一样。我直译跑了十张,八张跑偏成草莽宴;拆解重跑四轮,才出三张真正有建安气象的。
对酒当歌ai绘画这个题,我起先是当娱乐做的,结果一脚踩进坑里。上周想给书房配一张月下举杯的挂画,随手把"对酒当歌,人生几何"的意境丢给模型,出来的东西让我愣了半天——篝火、肉串、粗布汉子举碗狂笑,气质直接跑到水浒去了。这四个字的画面跨度太大,模型只会抓最表层的"喝酒唱歌",这一篇就把我重新拆词重跑的过程记下来。
四个字直接喂进去,会得到什么?
把"对酒当歌"原样喂给模型,十张里八张出成草莽汉子篝火举碗,气质跑偏到水浒去了。诗意词的意象跨度太大,模型抓不住情绪,只能落最表层的喝酒画面。
我不死心,特意用通义万相2.2跑了整十张做对照,文心一格补了五张,结论一致:直译词的产出高度雷同。八成是酒馆或篝火,人物一律五大三粗,月亮有是有,但挂得像背景板。有两张干脆画成了KTV麦克风配酒杯,现代元素乱入,看得我哭笑不得。这不能怪模型笨——"对酒当歌"里没有一个具体名词,全是动作和情绪,而模型认物不认情。
文心那五张倒是有两张走了水墨路线,可惜人物手势崩了,抚琴的手长出六根指头。这轮实验最大的收获是想通了一件事:给模型的提示词,得自己先把诗翻译成"东西"。
把诗拆成五层元素,才是正路
把诗拆成人物、动作、酒器、环境、情绪五层元素分别写进提示词,古意立刻立得住。模型不懂意境,但认得每一样具体的东西,名词越准画面越对。
我的拆法是这样的。人物层:束发、广袖、素色深衣,去掉一切铠甲和胡须拉碴的词——那是草莽味的主要来源。动作层:举杯邀月、抚琴而歌,二选一,别贪。酒器层是重灾区:我写"青铜爵",六轮里四次画成西式高脚杯,后来老老实实补英文"ancient Chinese bronze jue, three-legged wine vessel",四次里三次就对了。环境层:月色、庭院、烛台、石案。情绪层最后压一句"慷慨苍凉"。
给你看一个我磨出来的对照,两张提示词的差距一目了然:
| 写法 | 提示词示例 | 结果 |
|---|---|---|
| 直译 | 对酒当歌,古人喝酒唱歌,月亮 | 十张里八张草莽宴,气质跑偏 |
| 五层拆解 | 束发广袖文人,举青铜爵对月而立,庭院石案烛台,冷月青灰色调,慷慨苍凉 | 第四轮起三张可用,古意立住 |
拆解之后也不是一帆顺。翻车照旧有:广袖垂进酒樽里的、案几上漆器耳杯悬浮半寸的,我都留着当反面教材。总体算下来,从直译到可用成片,前后一个晚上加半个下午,十四轮。要是早知道拆法,起码省六轮。
宴饮的光和色,决定有没有古意
宴饮场面的古意一半靠光色:冷调月色打底,加一点烛火暖光点睛,避开大红灯笼。青灰配暖橙的对比,是建安风骨和唐宋酒楼的分界线。
我踩的最大一个坑是颜色。第一版拆解词里我顺手写了"红灯笼、宴席",出来直接是唐宋酒楼开业现场,热闹得像庙会。后来把光源砍到只剩两个——一轮冷月加一盏烛台,画面立刻安静下来,人物的影子拉长在地上,那股苍凉劲儿才出来。英文写法大概是"moonlit courtyard, cool blue-grey palette, single warm candle glow"。
饱和度也要收。古风题材有个反直觉的规律:颜色越少,年代感越强。我那张最后裱起来的成片,整个画面就青灰、月白、烛火橙三个色系。对了,手动留白也管用——让石案占画面三分之一,其余全空着,比塞满背景高级得多。
那张月下举爵的图,现在就挂在我书房,朋友来了都以为是找画师订的。回头再看开头那句直译喂词的翻车,我反倒觉得挺值——不懂模型的脾气之前,我以为写诗给它听就够了;现在明白,得先替它把诗拆成它能认的东西。对酒当歌这四个字的古意,从来不在字面,在月色、酒器和那一袖素色里。
常见问题
为什么AI总把中式酒器画错?
训练数据里中式酒器的图片占比低,模型抓到"酒杯"就近取材成西式高脚杯。写具体器型名再补一段英文注释,比如三足青铜爵的写法,命中率能明显回升,我实测从四成提到七成以上。
新手想练古风,从哪类诗下手?
挑名词多的。"月下独酌"好画,"将进酒"难画,因为前者有月亮、花间、酒壶这些实物,后者全是情绪和气势。先从能拆出五层元素的句子练,跑通了再碰抽象的。
画出来总像游戏立绘怎么办?
多半是光给太满、颜色太艳。砍掉一半光源,留一轮月亮一个烛台,饱和度整体往回收,再留一块大空白。古意这个东西,是靠"空"撑起来的,不是靠画满。
要不要垫图?垫什么安全?
垫国画、老画册的图有用,能快速锁定笔触和配色。别垫影视剧剧照去还原演员长相,风格参考和肖像生成是两回事,后者容易踩肖像权的线。