AI绘画反被AI下毒?模型吃了太多AI图会变成什么样
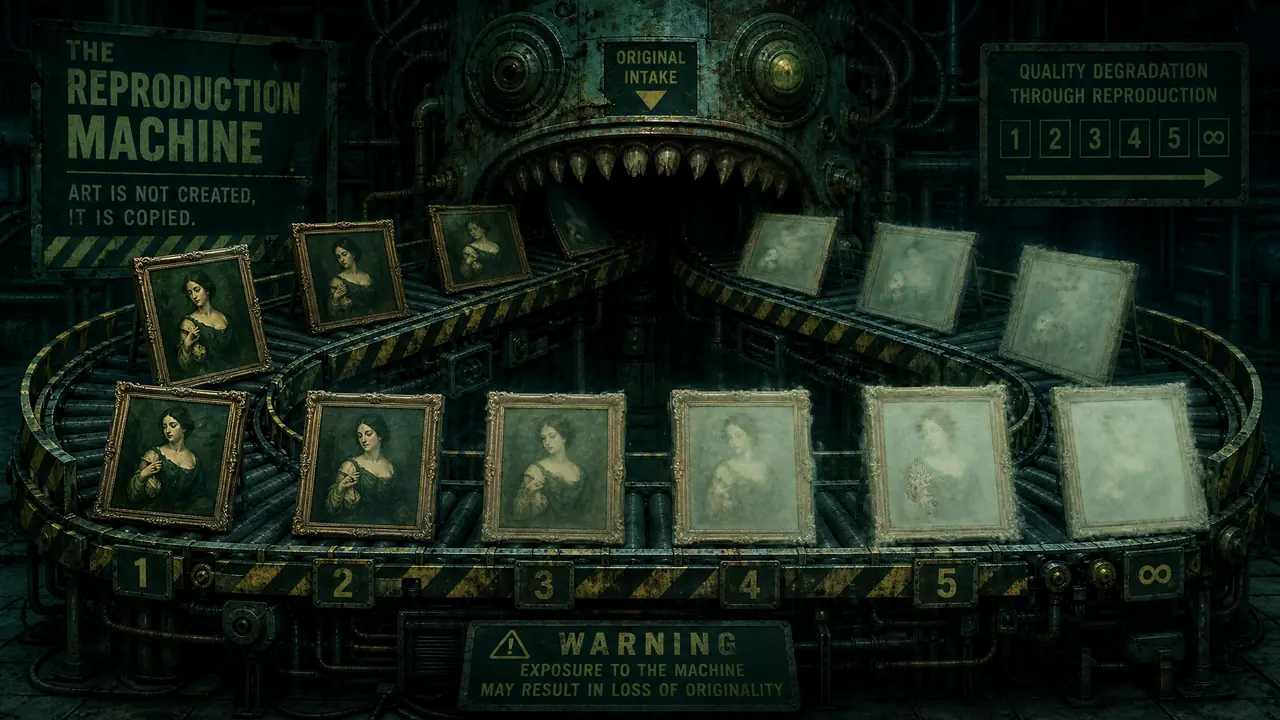
一句话版本:AI下毒有两层意思——AI图回流训练把模型慢慢喂"笨",这是真事;往图里加对抗贴纸想躲开爬虫,效果被传得神乎其神。你真正该做的就三件事:存原图、标注AI、别指望净化贴纸保平安。
AI绘画反被AI下毒,这个说法我第一次在群里看到时还以为是新出的什么恶意软件,点开图才发现是讨论模型退化。琢磨下来这词确实传歪了,两种完全不同的事被搅在一块讲,吓人的和真正要紧的混在一起。这篇把它拆开,哪些是真的,哪些是标题党。那天晚上群里吵到十二点,一半人在转发"自救教程",一半人在问这词到底啥意思——我属于后者,于是有了这篇。
先给个坐标系:这事跟单个用户的关系,远没有跟整个生态的关系大。你画的图不会因为你贴了张"防爬贴纸"就得到保护,模型也不会因为吃了你那张图就当场变笨——变笨是慢性的、大规模的,跟一个人的动作关系不大。
"AI下毒"这个词到底指什么
它混着两件事:一是模型公司拿含大量AI图的数据训练下一代模型,导致质量退化;二是有创作者故意给图加干扰,想让模型学不会自己的作品。前者有研究支撑,后者基本是心理安慰。
第一件事的背景不复杂。训练数据从哪来?从网上刮。网上现在有多少图是AI画的?比例一年比一年高。模型吃下去的图里混着自己的"孩子",再下一代接着吃,就这么滚起来。社区里管这叫模型近亲繁殖,说法糙,理不糙。顺带说一句,这词能火还有个催化剂:某些自媒体把研究论文里温和的措辞翻译成了"AI吃AI会中毒",标题越吓人,转发越多。
第二件事更像是行为艺术。有人给作品叠加肉眼几乎看不见的噪点,或者贴满小贴纸,逻辑是让模型"看不懂"这张图,学也学不走。这个思路在学术上叫对抗样本,本身成立,可到了"保护我的画"这个场景,效果就得打折了——后面讲我的实测。
AI图回流训练,模型会怎么变笨?
退化不是突然变丑,而是多样性塌掉:细节越磨越平,造型越来越像,错误开始自我强化。我做了个十轮图生图实验,第五轮手指先崩,第十轮连脸都丢了。
实验很简单。挑一张我自己挺满意的图,喂给图生图,把重绘幅度开到0.35,出图后再把结果喂回去,循环十轮,中间不改任何提示词。记录如下:前两轮几乎没变化;第三四轮开始,背景里的书堆悄悄合并成两摞;第五轮,人物右手出现六根手指;第七轮,画面里所有杯子长得一模一样;第九轮,瞳孔高光的位置左右不一致;第十轮,脸已经糊成一团,构图倒是还记得。
一轮是二十秒,十轮也就三分多钟,可这个过程把"回流"的病理性演得很直白:每一代都在丢失一点信息,模型又特别自信地把丢掉的部分"脑补"回来,脑补的样式还千篇一律。放到训练层面,几千万人天天生产的AI图被刮回去训练,就是把这个三分钟的实验放大到亿级规模。术语叫模型坍缩,你记不住没关系,记住"越吃自己越笨"就够了。
对抗贴纸那些"毒图",真有那么神吗
我的实测结论是不神:给图加上干扰贴纸后喂图生图,构图和配色照样被学走,干扰挡住的只有像素级细节。把它当护身符,不如把功夫花在存原图和留证据上。
我挑了张静物图,按群里流传的做法叠了四张所谓"毒贴纸",又加了层轻噪点,然后老规矩喂图生图。结果出来的图构图学了个七七八八,色调也是那个色调,只是贴纸位置的纹理有点怪。说白了,防御只对"精确复刻像素"有效,而模型学习要的从来不是像素,是规律。
还有一层没人提:这类对抗扰动是针对特定模型版本调的。模型一升级,扰动基本作废,你得重新"下毒"。我又补了个小测试,把加了贴纸的图压成缩略图再喂回去,干扰直接失效——扰动强度跟压缩也有关系,经不起转手。把希望寄托在一张会过期的贴纸上,不如把原始文件、图层记录、创作时间线都留好——真遇到搬运维权,这些才是硬通货。
说回标题。被下毒的不是哪一张画,是"AI生成—发布—被抓取—再训练"这个循环本身。个人挡不住循环,但能不被吓唬:存好原图,老老实实标注,看到"一张贴纸让AI学不会你"之类的说法,笑一笑就划过去。模型的事,让模型公司头疼去。
常见问题
我发布的AI图会被拿去训练吗?
取决于平台条款,有的平台在用户协议里写了会用生成内容改进服务,有的允许你关闭。发布前去设置里翻一眼,比事后追着问管用。
模型退化对我现在出图有影响吗?
短期几乎感觉不到。退化是版本迭代层面的事,主流厂商也在做数据清洗来对冲。你感知到的更多是"新版出图风格变了",那不全是退化。
那十轮实验能说明训练层面的问题吗?
不能画等号,图生图回流和大规模训练不是一回事,但衰减的方向是一致的:多样性丢失、细节糊化、错误自我强化。实验的价值是让你直观看到这个过程。
以后AI绘画还能用吗?会不会越来越差?
能,而且主流模型短期内没有变差的趋势,厂商对训练数据筛得比前几年严。真要担心,担心的对象也该是拿网图无脑喂模型的小作坊,不是你手上的工具。