把AI绘画还给AI:生成图回流训练这个循环,怎么看怎么办
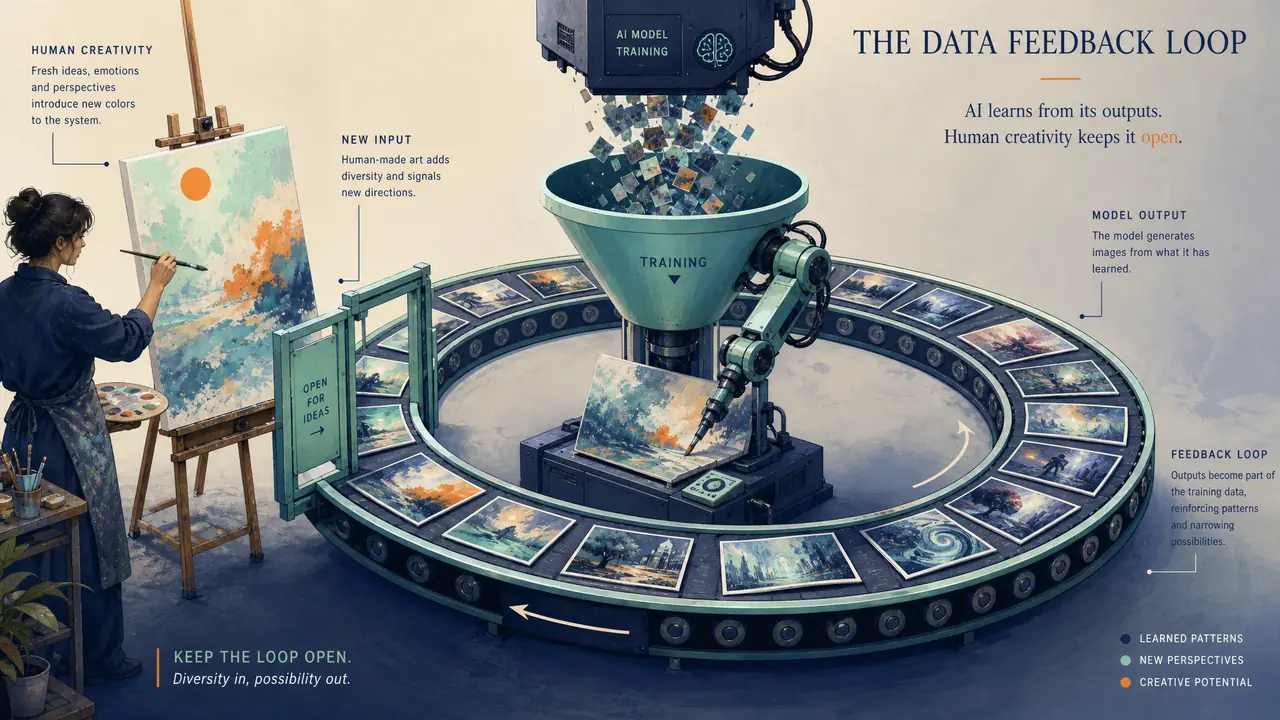
亮出立场:生成图回流训练是个真实存在的循环,但「AI吃自己尾巴马上变傻」是夸大,「毫无影响」也是天真。我的看法是循环本身不可怕,怕的是循环里只剩AI的图,人的新图断了供。
群里为这事吵过一晚上。有人说「以后网上全是AI的图,AI学着学着就学傻了」,有人说「想多了,规矩多着呢」。把AI绘画还给AI这个说法,指的就是这个现象:模型生成的图发布到网上,被下一轮数据采集收走,进了后来模型的训练集——生成物变成了养料。我先把话说清楚,这只是公开讨论过的技术现象,我拿自己能做的观察来聊聊,不下学术结论。
回流是怎么发生的:一条看不见的传送带
流程大致是:模型生成图片、发布上网、被数据采集收录、混进下一批训练数据。每一环单独看都正常,连起来就成了闭环。
拆开看每一环,其实都没毛病。创作者发图天经地义,搜索引擎收录网页是本职,模型方采集公开数据训练下一代也是老做法。问题出在比例上:早年网上的图全是人画的,近几年AI生成的图占比肉眼可见地涨——这点做图库、做素材站的人感受最直接,投稿里AI图一多,人工筛选的活就重了。图混进训练集的时候,模型并不知道哪张是人画的、哪张是它的「孩子」。
「AI近亲繁殖」这个比喻所以流行,是因为它抓到了要害:训练数据如果越来越少样,模型学到的世界就越来越像它自己产出过的世界。这个担忧2023年前后就有研究者公开讨论过,模型退化的说法大体由此而来。比喻归比喻,机理是真问题。
补一个素材站视角的细节。我认识一位经营素材站的站长,他说现在每次上新前的人工筛选,AI图占了看稿量的一半以上,其中还得再剔掉一批标注不实的——挂着「手绘」名头的AI图混进来,对买图做设计的人是实打实的坑。传送带的入口处,掺的东西比多数人想的杂,这也是我后面强调标注的原因。
退化真的会发生吗:我的小观察
小规模回流的影响被夸大了,规模化的同质互喂才是隐患;真正的变量是比例和多样性,不是「碰没碰过AI的图」。
我自己做过一组小实验,跟这事沾边。把同一张图反复喂回模型,十代之后细节塌得只剩个影子——这个实验说明「模型持续消化自己的输出」确实会丢信息。但也要说清,这跟行业级的回流不是一回事:我那组是封闭循环,一张图反复转;真实世界里训练集是海量混合的,掺进一部分生成图,还有清洗、去重、筛选好几道工序在前面挡着。几万分之一的回流,跟百分之百的自我消化,完全两个量级。
所以我的判断是:不必恐慌,也别不当回事。真正值得盯的是两件事——训练数据里AI图的占比会不会越来越高,以及数据源是不是越来越单一。前者看平台的标注体系,后者看模型方买不买授权数据。这两年各家平台陆续上了AI内容标注,模型方也在谈数据授权,方向是对的,速度嘛,我个人觉得还不够快。
创作者该怎么办:做循环里的淡水
普通创作者三件事:发布时如实标注AI成分、保留自己原图的创作凭证、持续产出有个人经验的真东西。人的新图,是这个循环里的淡水。
第一件事是标注。自己画的说自己画的,AI辅助的如实说,别来回横跳。标注体系要起作用,靠的就是每个人的诚实,标签乱了,筛选这道闸就废了。第二件事是留凭证。源文件、过程稿、时间记录,别嫌麻烦,版权扯皮的时候这些就是你的底牌。第三件事最重要,也最难:持续产出带着真实经验的图。AI画的图再漂亮,它是平均值的产物;你画的是具体的生活,某个镇上的早点摊、某场没赶上的火车。这类东西,模型的数据集里永远缺。
「把AI绘画还给AI」这个说法,我愿意换个角度收尾:还可以还,但要连着人的部分一起还。循环里只有AI的输出,退化是迟早的事;人的新图不断进来补水,这个循环才有生态可言。创作者与其焦虑自己的图被收走,不如把心思放在「下一批数据里,有没有只能由我产出的那一份」。
吵了一晚上的群,最后没吵出结果,倒是有人默默发了一组自己最近的写生,底下一排人点赞。技术层面的循环,有平台、模型方和研究者在操心;创作者能攥在手里的,就是那支不停下的笔。AI绘画还给AI可以,人的部分,攥紧点。
常见问题
AI生成图进入训练数据,会让模型退化吗?
少量混合且有清洗筛选的回流,目前看影响有限;规模化的同质互喂才是隐患。关键变量是占比和多样性,不是碰没碰过。
平台标注AI内容对这件事有什么用?
标注是筛选的前提。数据采集方靠标签区分人画和AI生成,标签准了,训练集的配比才可控,循环才谈得上被管理。
普通画师怎么保护自己的作品?
保留源文件、过程稿和发布时间记录,必要时有凭证可查。水印和署名挡不住全部抓取,但凭证能帮你在争议里站住。
为什么说人类新图是循环里的淡水?
AI的输出是已有数据的平均值,人的创作带来新的、模型没见过的东西。没有新鲜输入,模型学的世界只会越来越像它自己。