ai写文案ai绘画怎么配合?文案定调、画面跟走的流水线
流水线只有一句话:文案是甲方的甲方,画面是乙方。先定调再出图,单张配图八分钟搞定;顺序反了,返工的时间是出图的五倍。
ai写文案ai绘画这两件事凑一起,很多人干成两张皮——文案写的是清晨薄雾里的清爽,配图却浓墨重彩像傍晚的酒吧。问题不出在工具,出在顺序:图先出、文案后凑,图文永远对不齐。
我给一批社媒和推文配图用了大半年,摸索出的规矩就一条:文案定调,画面跟着走。下面把流水线拆开讲,包括我翻过的车。
为什么必须先写文案再出图
文案决定画面的情绪、主体和场景三要素,顺序颠倒意味着画面没有锚点,出图全凭感觉,返工率翻倍。先把文案写死,是最省钱的一步。
我做过对比。早先的习惯是先出图,看着图写文案,结果经常是好图配不出话——画面信息太多,文案只能挑一角说,图剩下那七成全成了干扰。后来改成文案先行,情况完全反过来了:文案给了明确的靶子,出图从「碰运气」变成「填空题」。
有个更实际的原因:文案改起来五分钟,图改起来半小时。让便宜的一步先动,贵的跟着改,这笔账不难算。
一条实操记录:四月底那批茶饮文案,我是先把全部二十六条写完锁稿,才开始配图的。中途甲方临时砍掉三条,直接跳过就行,一张图都没浪费。反过来要是先出图,砍掉的三条就是我白熬的三个小时。
文案写到什么程度才配动手出图?我的标准是文案定稿——标题、正文、语气全部锁定。半成品文案配图,等于给一句随时会改的话画肖像,白忙。
文案怎么拆成画面指令
拆三样:情绪词翻成色调和光线,名词翻成画面主体,场景词翻成环境背景。一张配图只服务文案的一个核心意思,贪多必乱。
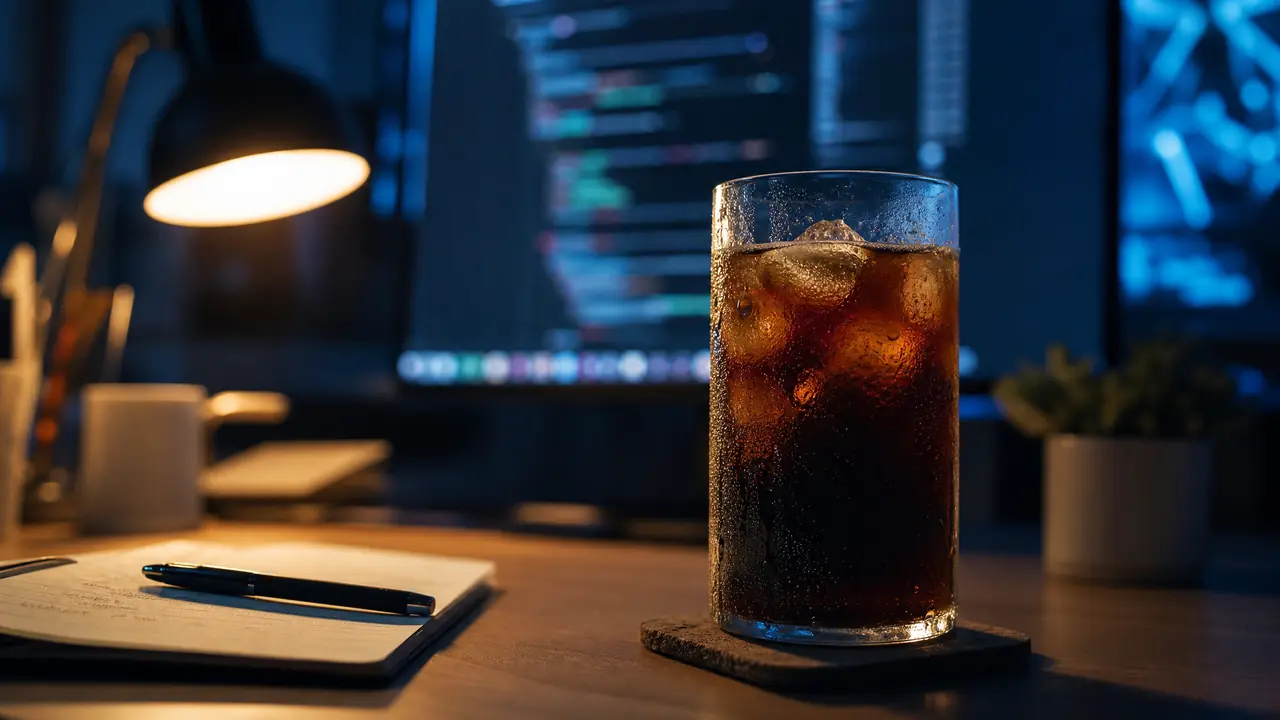
拿一条我实际用过的茶饮文案举例:「加班的深夜,一杯冷萃把人捞了回来。」拆下来:情绪词是深夜、疲惫、被救,色调定为冷蓝加一点暖黄光源;名词主体是冷萃咖啡杯;场景词是深夜办公桌。合成的画面指令大概是「冷色调办公桌上的一杯冷萃,杯壁水珠,背景虚化的电脑屏幕,一盏暖黄台灯」。这一张图后来是那批文案里互动最高的。
| 文案元素 | 翻译方向 | 示例 |
|---|---|---|
| 情绪词 | 色调与光线 | 治愈→暖光低饱和;提神→冷色高对比 |
| 名词主体 | 画面唯一主角 | 一杯冷萃、一把伞、一双跑鞋 |
| 场景词 | 环境与背景 | 深夜办公桌、雨后街角、清晨厨房 |
情绪词的翻译最值得练。我攒了半年大致有个映射:写「干净」就上留白和大面积浅色,写「热闹」就堆前景层次,写「治愈」用暖光加毛绒质感。反例我也存了一堆——文案说「轻盈」,AI给你画气球和羽毛,俗气得整齐划一,这种时候得换成「悬空的、无重量的」这类更物理的描述。
出图之后:核对三问和翻车实录
每张图过三问:画面的主角和文案说的同一个人或物吗?情绪对得上吗?有没有文案没提的多余信息?三问全过再上线,能拦下大部分图文两张皮。
翻车实录讲两条。第一条是那批茶饮文案里的翻车款:文案主打「清爽」,我图里给杯子加了雾气腾腾的热感——AI默认热饮冒烟。发出去当晚有评论区问「冰的怎么冒热气」。第二天重出,加了「condensation droplets, iced」,水珠一上,文案和图才算说的一国话。
第二条更隐蔽:给一条倡导早睡的推文配图,画面是个温馨的床头灯场景,三问全过。上线后同事指出,闹钟显示的时间在画面里特别扎眼,跟文案说的「不用管几点」打架。这属于第二问的延伸——情绪对不对,还得看细节元素有没有在偷偷唱反调。
核对三问看着繁琐,实际熟练后每张图三十秒。比起发出去之后被评论区挑错,这三三十秒是我花过最值的。
效率账也顺带一提:这批文案一共二十六条,配图花了大概一个下午加一个晚上,单张从拆文案到定稿平均八分钟。以前我随便出图再挑选的做法,单张要耗四十分钟,还未必对题——省下来的时间够我再改两轮文案。
这套流程走顺之后,配图在我这儿从「创作」变成了「翻译」——把文案的语言翻成画面的语言,词对词地对应过去。
翻译准了,图文自然咬合;想靠一张万能美图糊弄所有文案,才是两张皮的根源。
常见问题
一张配图要配多少个画面元素?
一个主角加一个背景就够。文案一句只说一件事,图也一样。元素超过三个,观众的注意力就开始打架,图的记忆点反而消失了。
文案和配图必须严格一致吗?
基调必须一致,细节可以留一点反差。比如治愈系文案配一张略带孤独感的图,张力反而更强。但主角和情绪不能拧着来,那是硬伤。
没有绘画基础能干这个吗?
能,这条流程里没有任何画画环节,考验的是阅读理解——读懂你自己的文案。语文过关,配图就不会太离谱。
批量文案怎么提高配图效率?
按情绪词分组出图。同一批文案里治愈系可能有五六条,一套色调和光线参数可以复用,只换主体,单张耗时会从八分钟压到四分钟左右。