GPT AI修图能听懂人话吗?我把修图需求写成对话喂给它
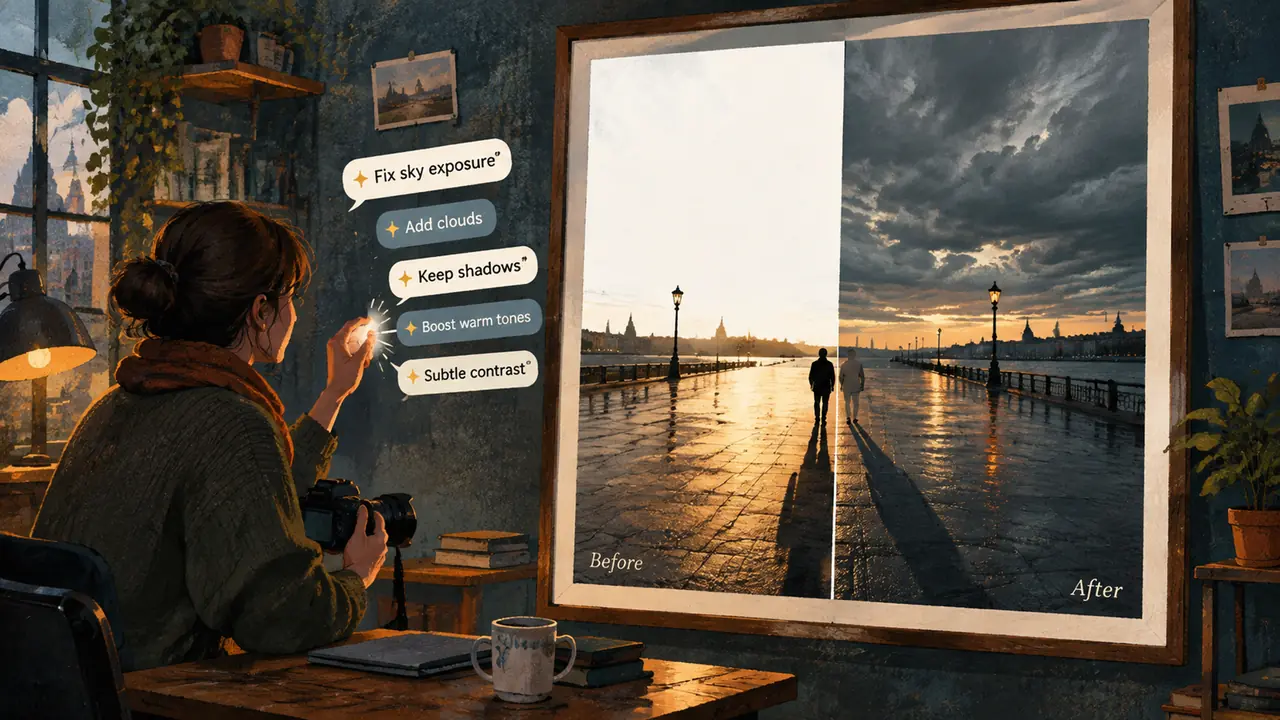
先泼点冷水:GPT AI修图大概能听懂你七成人话,剩下三成得靠你换个说法再喂一遍。「换背景、压天空、去路人」这类明确指令它接得又快又稳,「氛围感、高级一点」这种玄学词它就开始瞎猜。想拿它当修图助手,先把需求写成具体句子,再做好来回改三四轮的心理准备。
我喂给它的第一句话,和它先干的三件事
GPT AI修图最试探人的一步:把修图需求当聊天发过去,它会先用自己的话复述一遍你的要求再动手,听懂没听懂在这一步就能看出来。复述对了,后面基本稳;复述歪了,趁早改口。
先交代背景:我是那种周末背着相机在北京城里瞎转的业余玩家。8月30日傍晚在后海拍了一张人像,逆光,天空死白一片,但地面上的影子拉得很长很好看。回来我打开GPT AI修图的对话窗口,没写任何提示词模板,就照着脑子里那句话敲过去:「把背景换成阴天,但要保住影子。」
它没有直接出图,而是回了三件事。第一,复述:「将背景替换为阴天多云的天空,同时保留前景人物的投影和地面长影。」第二,问了一个我没提的细节:「希望阴天是灰白均匀,还是带一点云层层次?」第三,给了预计耗时:约25秒。说实话,就冲这个复述环节,我当时的期待值拉高了一截——至少它知道「保住影子」是重点,没把整张图重新打光。
25秒后出图。天空换成了带层次的灰云,影子还在,方向和长度都对。第一把就中,这种体验在传统修图流程里等于省掉了抠图加换天空那大概四十分钟。我后来又试了「把左边入镜的大爷去掉」「整体调亮一点但别过曝」,成功率都不低。你如果是那种能明确说出要什么的玩家,开局体验会相当顺。
听岔的几次,比听懂的更值得记
它最容易听岔的是模糊形容词和空间方位词,「高级一点」「往左挪」这类词十次里能猜歪三四次。判断标准很简单:你说不清,它就替你瞎编。
翻车从第二轮开始。我看第一版顺眼但缺点意思,敲了句「氛围再压一点」。结果它把饱和度直接拉到了估计-40的位置,整张图灰得像蒙了层土。我又说「高级感一点」,它给我加了重暗角加橙青色调,好家伙,直接塞进了2021年那种烂大街的电影感滤镜。这两个词是它替我做主的重灾区。
最有意思的一次是第五轮。我说「影子往左挪一点」,它把影子镜像翻转了。不是移动,是镜像——影子从人物右后方跑到了左前方,物理上都不成立,太阳从西边出来了。我对着屏幕笑了半天,然后老老实实改口:「保持影子形状不变,把整张画面水平翻转。」它这次做对了。
还有一次更冤。我说「别动人物的脸」,它就真的一根手指都没碰脸,但顺手把人物的衣领颜色也换了,因为它把「别动」的理解范围框在了「面部区域」。你跟它说话得像跟一个字面理解能力极强、常识储备忽高忽低的实习生交代活:每个边界都要划清楚,它不会帮你多想一步,也不会自作聪明到哪去——除了那几个形容词。
三轮下来我摸出个规律:名词加动词加数字的句子,几乎不翻车。「天空亮度降15%」「去掉水面反光」「色调往冷调偏一点」全一次过。形容词单独出现就悬,要么带上参照物说「像清晨六点的天光」,要么干脆别用。这条经验比任何教程都省事。
来回改几轮才到位,这个效率划算吗?
同一张图平均喂四轮对话、每轮等二十来秒,两分钟内能到「可发朋友圈」的水准,比手动流程快一个量级。但要做到精修交付级,它目前还接不住最后一公里。
我算过一笔账。9月2日到4日三个晚上,我一共喂了它六张图,平均每张四轮对话,最快的一张两轮到位,最慢的第七轮我才认输手动收尾。按每轮25秒算,六张图花在对话上的时间加起来不到十二分钟。同样的活放回老流程,光是把后海那六张的天空挨个抠出来换掉,我估计得耗掉小半小时起步。
但账不能只算一半。第七轮认输那张是个半身特写,我说「发丝边缘再干净一点」,它在发丝和阴天背景之间糊出了一圈灰边,改三次都没改对,每一轮它都很有礼貌地回「已优化边缘过渡」,然后糊得更有想法。这种毫米级的局部处理,目前还是得回Lightroom里手动刷蒙版。我最后的做法是拿它出的图当底,手动只救发丝那五分钟——先让它干粗活,细活自己收。
所以划算与否取决于你的图要干嘛。发社交、选片预览、给客户出方向小样,对话两轮就能停手,血赚;要印出来挂墙上或者交付精修,把它当第一个小时里那台干粗活的机器就好。想再横向比比别家的工具,可以看看那篇AI智能修图五款工具横评,各家的听话程度差异不小。
回到开篇那个问题:它听懂人话了吗?七成是有的,剩下三成不是它笨,是我话说得糙。这三个晚上最大的收获反而是倒逼我把「我到底想要什么」想清楚了——能对人说明白的修图需求,机器才接得住。下一张图,我打算先在心里把那句话打磨顺了再敲回车。
常见问题
对话式修图能直接处理RAW格式文件吗?
我实测的入口只认JPG和PNG,RAW得先在Lightroom里导出一份16位TIFF再喂进去,色彩信息基本能保住。如果你习惯用代码调接口批量处理,那篇用代码调用AI修图接口里有更工程化的路子,比一句句聊天适合量大的时候。
中英混着说,它还听得懂吗?
听得懂,而且有时候英文术语反而更准。我试过「把clipping的高光救回来」,它直接理解成降低高光曝光,没绕弯。倒是纯中文里「死白」「闷」这种行话它偶尔要猜,换成「高光过曝区域压回细节」就稳了。
我发给它的照片会被拿去训练吗?
设置里有个数据用于改进模型的开关,默认状态我建议你自己进Settings的Data Controls里核实一遍再关。涉及客户肖像或未发布商业片的图,我都是关掉开关后才传的,这个习惯你最好也保持。
一次对话里能连续修很多张图吗?
能,但别在一个会话里超过十张左右。我喂到第八张时它开始混淆前面说过的「别动脸」「保住影子」这些约束,把上一张的指令带到了下一张。每张图开一个新对话,把需求完整重发一遍,反而更快。