ai修图写真避坑记:三成不像的脸,问题在源头
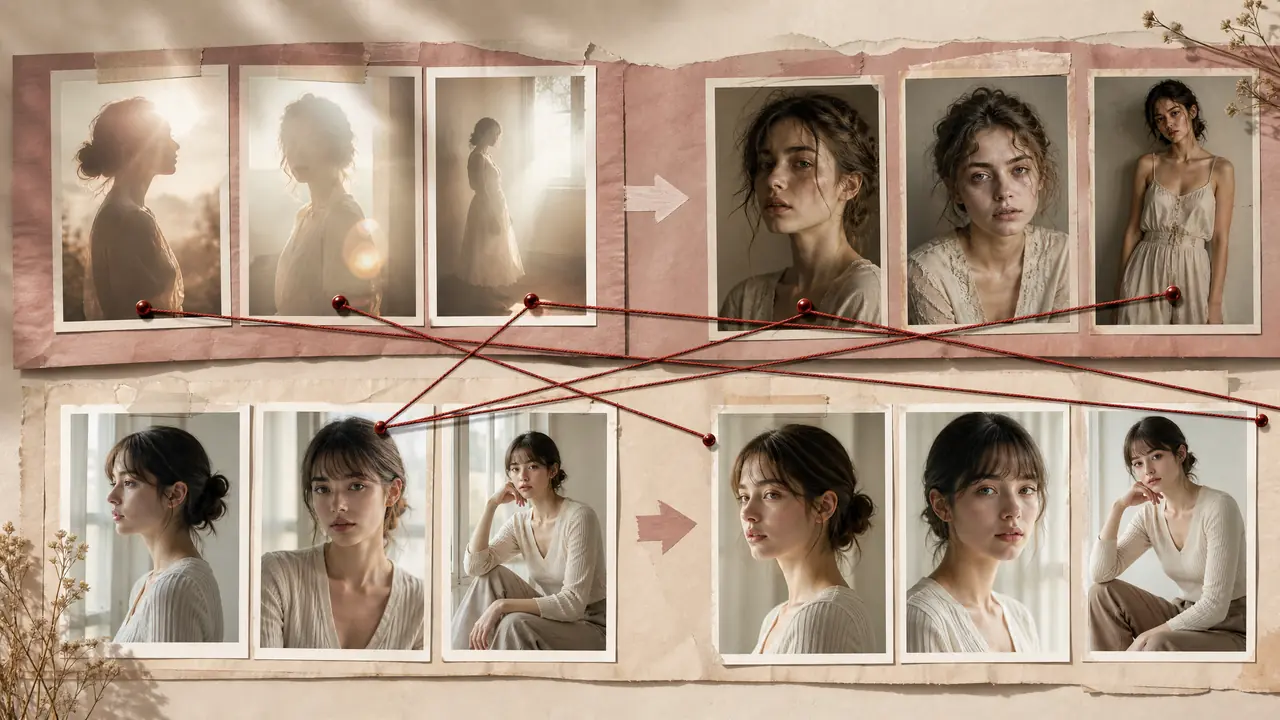
先泼盆冷水:写真出片不像本人,八成是源图的锅,不是修图的锅。我做过一组对照实验,换源图比调参数管用得多,数据和规矩都在这篇。
ai修图写真最让人泄气的时刻,是成片里的自己看着眼熟却不敢认。上个月我帮朋友做一套二十张的写真,风格选了室内柔光那种,十张样片发过去,她圈出六张说「这不像我」。第一反应是参数问题,调了两轮没起色,才回头查源头——这一查,前面的功夫全白费。
朋友的诉求很普通:发朋友圈和社交平台,要的是「一眼是我,又比日常精致一点」。这个标准不高,也是大多数人的标准,所以这次的教训对普通人才有参考价值。顺带一句,她最后最满意的那张成片设成了微信头像,用到现在没换过。
六张不像的脸,废因拆开看
六张废片里四张的源图有脸部遮挡或逆光,两张是源图表情太少导致AI平均化。废因全在源头。
逐张对回去看:四张的源图是逆光环境拍的,脸部欠曝,AI拿到的五官信息本来就不全,生成时只能「猜」,猜出来的脸是它的平均审美和你五官的混合物。两张更隐蔽,源图没遮挡也不暗,但只有一种表情——都抿着嘴。AI在轻微微笑和露齿笑之间反复横跳,嘴形每张都对不上她的习惯。
找废因花了我一个晚上,方法很土:把源图和成片并排打印出来贴墙上,一张张连线。源图自己有毛病的,问题多半出在源头;源图好端端的,才轮得到怀疑生成参数。
还有一张的废因有点冤:源图本身没问题,坏在我批量跑了同一个指令——那个场景该用偏侧光的描述,我偷懒沿用了正面光的写法,AI把她的鼻影修没了,整个人像被拍扁。所以废因清单上也该给「指令用错场景」留一行,它不属于源图,但同样出在源头。
源图对照实验:换图比调参管用
同一风格下,优质源图出片十张九过,弱源图调参两轮仍有五成不像。差距没法用参数填。
实验设计不复杂:从她的照片库里分两组源图,A组是白天窗边自然光、五官无遮挡、表情丰富的十二张;B组是原始批次里逆光和表情单一的八张。同一套风格指令跑,A组出片我挑了十张,她一眼认出九张;B组调了两轮参数,十张里她只认五张,还说「像但不敢发」。相似度差距大到没有悬念。
更实惠的发现是成本:A组从源图到成片平均每张八分钟,B组两张废片的返工时间就够A组出三张。这不是技术差距,是源头差距。跟ai写真和实拍怎么选?按用途对号入座里「源图决定上限」的说法能互相印证。
实验里还有个细节值得写:A组那九张被认出的成片,她指着其中三张说「这张连我左边笑起来的梨涡都在」。梨涡这种细节,参数调不出来,源图里有,成片里才有。AI不会发明你的特征,它只能放大你在源图里给足的信息。
挑源图的四条硬规矩
顺光、无遮挡、多表情、近景清晰,四条全占的源图才值得进流程。缺一条就先补拍。
顺光:脸部受光均匀,AI拿到的信息才完整,逆光剪影的浪漫留给自拍去。无遮挡:刘海、手、口罩、粗框眼镜,凡是盖住五官的东西都算,尤其别用笑到眯眼的图——眼睛的信息少一半。多表情:同一批源图里最好有大笑、浅笑、平静三档,生成不同场景时各取所需。近景清晰:脸部占画面三分之一以上,糊的源图喂进去,AI会按自己的想象补细节,补着补着就不是你了。
有人问手机前置行不行。行,白天窗边拍,别开美颜——美颜磨掉的细节AI会自己脑补,出来的脸瘦是瘦了,是别人的瘦。
补一组对照数字:按四条规矩筛源图,她照片库两百多张里一次过关的只有二十六张,过关率一成出头。别嫌少,二十六张够跑四套不同场景的写真还有富余。手机一年攒下来的照片,从来不缺数量,缺的是按规矩挑的这一步。
第二遍换上新挑的源图重新跑,二十张她认出十九张,剩下那张她犹豫了一下说「这张像我妈」。笑归笑,结论是实的:ai修图写真这件事,七分看源头,三分看修。下次看到不像的成片,先别怪算法,回头看看你喂了它什么。
常见问题
源图数量多少张合适?
十到二十张为宜,质量大于数量。我试过五十张的堆法,AI反而抓不住特征重点,精选十二张比随手五十张出片稳得多。
已经跑出来的写真发现不像,还能救吗?
能,思路是补源图不是改参数。补两三张清晰正脸源图重新生成那一场景,比在原图上反复局部重绘省时间,相似度恢复得也快。
不同风格之间,哪种最考验源图?
古风和浓妆风格最考验。妆造变化大,AI对五官的保留度会下降,源图必须更清晰更顺光才压得住,日系清透风对源图宽容得多。
写真成片发社交平台要注意什么?
重点两条:平台的AI生成标注选项按实勾选;别把源图和成图混着发,观感割裂,挑统一的成片组图发效果好。
情侣合照做AI写真难在哪?
难在两张脸都要锁住,一个人的源图问题会拖垮整张。经验是先把两个人的源图各自按四条规矩筛一遍,任何一方不合格就先补拍。