口述ai修图靠不靠谱?语音指令修图的实测
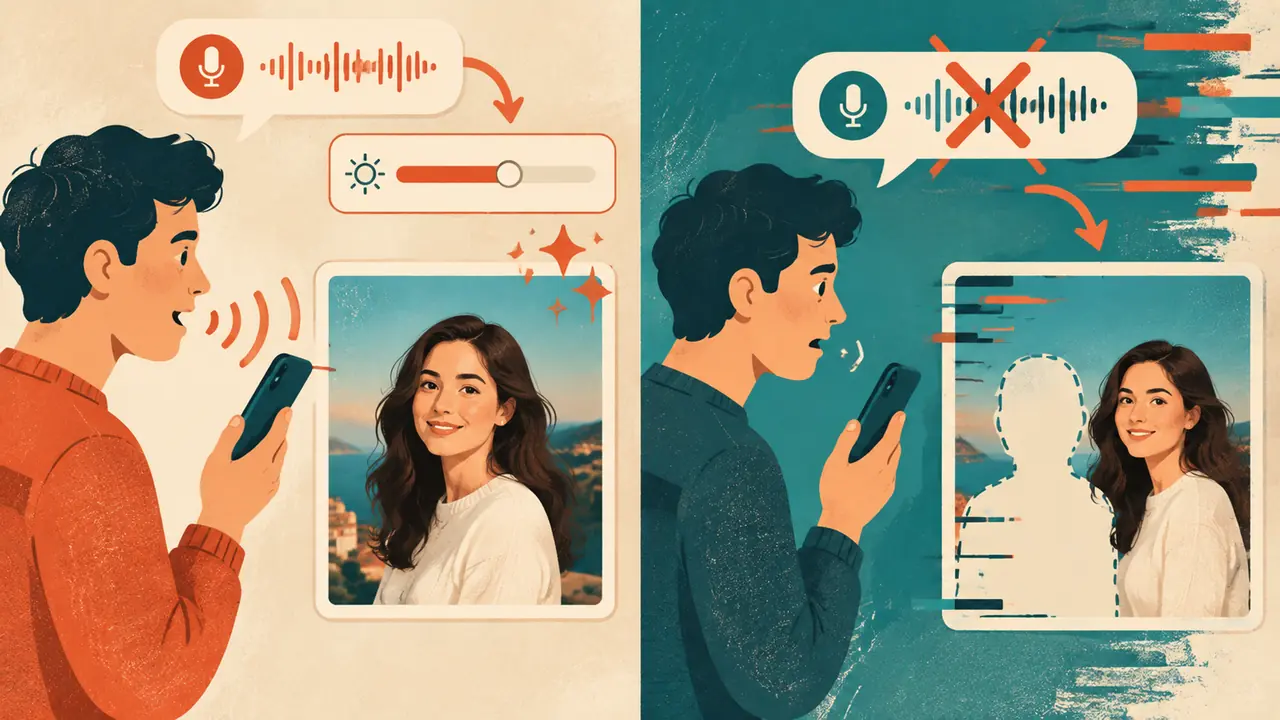
嘴比手快:口述ai修图在单步简单操作上靠谱,复杂多步指令先别指望。听错词和会错意是两层独立的坑,方言和噪音再各打一次折。建议先用语音做消除、翻转、调亮这类活,再学会语音加文字混着用。
口述ai修图靠不靠谱?结论先给:单步指令靠谱,复杂指令是赌运气。这两年我拿语音指挥AI修图测了不下二十轮,普通话、我妈的家乡口音、菜市场的噪音环境都试过,下面全是实测攒下来的数字。
先说结论之外的两层出错:听错词是一层,听对了却会错意是另一层
语音修图的错分两层:识别层把词听错,解析层词全对但理解歪了。前一层换个说法能救,后一层只能换回文字指令。分清这两层,你就知道该重说一遍还是该低头打字。
说翻车,今年3月那场直播到现在还有人在弹幕里提——我对着修图工具说「把左边的人去掉」,画面左边是个入镜的路人,右边是我朋友举着的自拍杆。AI安静了两秒,把右边的人整个抹掉了,路人原封不动站着。切片当晚就上了热门,网友玩了半个多月的梗,评论区最高赞是「AI的左边和你的左边隔着一个坐标系」。
复盘下来,问题出在解析层。我说的话它一个字都没听错,「左边」「人」「去掉」三个词识别日志里全对。它是把「去掉左边的人」理解成了「去掉右边的主体」——训练数据里可能见过太多主体居中的图,模型对「左边」这个方位词的权重本来就不稳。这层错你重说一百遍也没用,得换表达方式。
识别层的错就普通多了。8月底我整理了20条常用指令做回归测试,「锐化一点」在五轮里有两次被听成「软化一点」,方向直接反掉;「饱和度」更惨,10次里3次被转写成「包货度」或者干脆丢字。这就像小时候玩的传话游戏,一句话过三张嘴,到最后一个人口中变成了完全另一句。识别层的错有个好处:你换个说法往往能绕过去,「让照片更清楚」比「锐化」识别稳得多。
哪些指令能放心说,哪些必须换回键盘
单步指令是语音的安全区:消除杂物、翻转、整体调亮这类成功率能到九成上下;多步操作、带方位和程度的指令,失败率过半,建议直接打字。张嘴之前先判断你的活落在哪一边。
我把8月底那轮测试的数字摊开说。同一批20条指令,安静室内、标准普通话,连测三轮共60次:消除类(去路人、去水印、去电线)54次成功,成功率90%;水平翻转和旋转60次全对;「整体调亮一点」「稍微暖一点」这类全局调整成功53次,88%。这三类你放心说,说完瞄一眼预览图就行。
多步指令是另一个世界。「把背景换成海边,人物往左挪一点,再加点暖光」——三个动作,它在一次对话里要么只做第一个,要么三个全做但人物手臂直接糊成一片。位置关系也是重灾区,「左边第二个人」「右上角那个招牌」这种描述,它数数的水平约等于定位失败。还有程度词,「亮一点」和「亮很多」在它耳朵里区别不大,我遇到过调四次才到位的,每次都是重新说一遍整句。
所以我现在干活用的是混合流:语音起手,文字精修。上个月赶一批9张图的客片我掐过表——纯打字每条指令平均40秒,包括改错别字的时间;纯语音25秒,但有两张因为听错返工,算上返工摊到每张31秒;混合流是语音说大方向、键盘补关键参数,每张28秒且零返工。纯语音最快只是账面数字,混合才是真快。
有一类人从语音修图里拿到的好处比我们大得多。我爸七十岁,拼音忘得只剩个声母,触屏打一个字要翻三页候选词。教他说「把照片调亮点」「把后面的人去掉」,十分钟他就会了,现在每个月把老战友聚会的照片发我之前都自己先修一遍。对打字困难的人来说,语音不是锦上添花,是入场券。
方言和噪音环境,口述ai修图还剩几分靠谱?
安静环境说标准普通话,识别率在九成上下;带方言口音降到六成多;菜市场那种噪音环境再打对折。口音重的用户建议说短句,一条指令压在八个字以内。
8月底到9月初,我专门做了组方言和噪音的对比测试。固定10条指令,三种条件各说一遍:安静房间的普通话,28次识别正确;我妈那种带浓重家乡口音的「塑料普通话」,30次里对19次,识别最稳的是「消除」「调亮」这类短动词指令,「饱和度」「对比度」这种双音节专业词基本全军覆没,要么丢字要么转成一个不相干的词。第三种条件我把手机带到楼下菜市场,同样的普通话,30次里只对了14次,环境噪音一上来,工具连「翻转」都听成别的。
直接说方言更没法看。我拉了个四川朋友用川话喊指令,试了两款主流工具,方言没有被当成独立语料支持,识别率是个位数,十条里对不了一条。话说回来,这不能全怪AI——主流语音模型的训练数据里方言占比本来就小,这是行业现状,不是修图工具单独的锅。
噪音环境里有几个实操技巧能把成功率拉回来一些。手机举近,距离从一米缩到二十厘米以内,菜市场环境的正确识别从14次涨到21次;把长指令拆短,「消除」两个字单独说,比「帮我把画面里多余的人消除掉」稳;说完等预览刷新再说下一条,别连珠炮。这些技巧救得了七八成的场面,救不了全部——风声大的户外,我的建议就是别张嘴了,回去打字。
如果你想系统研究指令怎么写才能让AI少理解歪,不管是打字还是语音,那篇讲修图ai语句怎么写才管用的客服视角指令集可以接着看,里面对方位词和程度词的坑挖得更细。
嘴比手快这件事,前提是活儿足够简单。口述ai修图给我的真实体验是:单步指令它是合格的懒人神器,多步操作它是需要盯着的实习生,方言和噪音面前它还是个偏科生。3月那次删错人的直播我到现在还会被老观众刷梗,但它也逼明白了一件事——张嘴之前先想清楚这条指令是不是一句话能说完的,想不清楚,就低头用键盘。嘴和手不冲突,会用两个的人干活最快。
常见问题
语音修图对设备和网络有什么要求?
多数工具的语音识别走云端,弱网环境下延迟会从一秒内涨到三秒以上,超时还会直接丢指令,实测4G满格和WiFi体验基本一致,电梯里和地库这种信号抖动的地方经常识别失败。麦克风素质影响没那么大,手机自带麦克风够用,蓝牙耳机反而因为编解码压缩多一层转写错误,安静环境差别不明显,噪音环境蓝牙耳机的收音比手机本身更稳一些,因为可以凑近嘴边。
说错了指令,能用语音撤销吗?
主流工具里「撤销上一步」这条语音指令的支持情况参差不齐,我测过的几款里有的能听懂,有的只认界面按钮,还有的会把「撤销」转写成「调俏」。稳妥的做法是把「撤销」设为常用口令反复试一次确认支持,不支持就记住对应的手势操作。另一个坑是语音改口:说错之后马上说「不对,我是说……」,多数工具不会覆盖上一条,而是把两句都执行,结果就是图上叠了两层修改,撤回到最后一层才能清干净。
教老人用语音修图,先教哪几个功能?
按我教我爸的顺序:第一个教「调亮」,因为老人拍的照片十张有八张欠曝,效果立竿见影,成就感来得最快;第二个教「消除」,从去水印这种最简单的开始,别一上来就教去多人背景;第三个才是「翻转」。每条都让他们自己完整说三遍,你只看不动手。参数类的一律别教,亮一点暗一点他们能感知,色温饱和度说十遍也记不住对应关系。