修图AI视频封面:从视频里抽帧到出图的一套流程
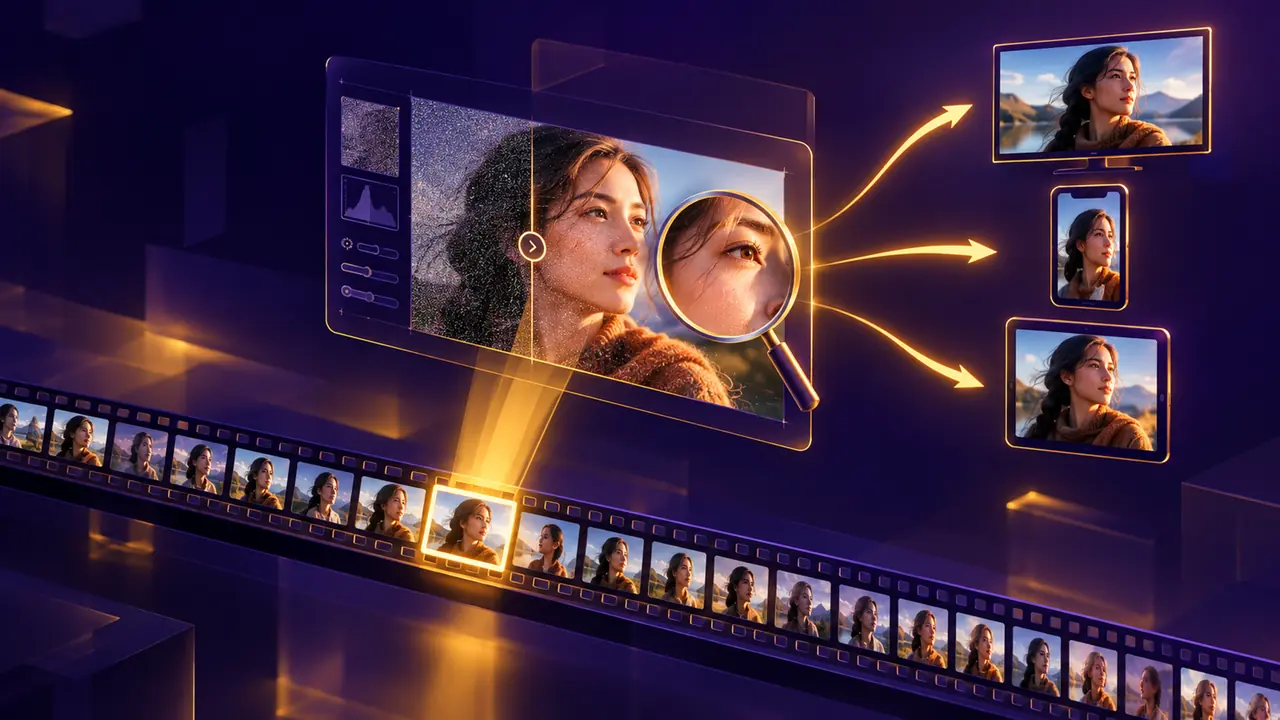
先报数字:一条十分钟的口播视频,我抽24帧,留下3帧修出封面,整套下来25分钟。视频帧和普通照片是两码事,压缩噪点、画质糊、表情废是三大坎,这篇把我给十几个视频做封面的固定流程拆开讲。
修图AI视频这个说法,说白了就是把视频里抽出来的帧当照片修。视频本身不用动,动的是从里面捞出来的图:封面用一帧,进度条卡点图用几帧,多平台发用时再出几版尺寸。这活我做了十几个视频,最初的版本又慢又糊,踩够了坑才磨出现在这套25分钟的流程。视频帧最大的敌人不是光线,是压缩。
抽帧别图省事,截图和导出是两个画质
播放器截图经过缩放插值,画质先损一道;用工具从原视频逐帧导出,帧就是原始分辨率。起点画质决定后面能救回几成。
我早期偷懒直接播放器截图,修图时怎么锐化都发糊,后来才明白是截图那一步就把像素插值坏了。改成逐帧导出之后,同样的修图流程,成片清晰度直接上一个台阶。选帧也有讲究:十分钟口播我一般抽24帧,每二十来秒一帧,先粗筛,再从十来张候选里留3张。选帧看三样:眼神看没看镜头、口型是不是闭着、手势有没有遮脸。
一个独家发现:人在讲到重点内容前后那两三秒,表情往往最有力,我后来的选帧习惯是先看文稿或者字幕的时间点,直接跳到那些位置附近抽帧,命中率比均匀抽样高得多。24帧里能出3张可用帧,基本稳定。
导出帧的具体做法:把视频拖进剪辑软件或帧提取工具,定位到目标时间点,导出当前帧为图片,格式选PNG别选JPG,能少一道压缩损失。粗筛的标准放宽松,表情不够好但构图好的先留着,修图阶段常常有意外惊喜;反过来构图废的表情再好也没用,封面是要讲究画面占比的。
压缩噪点和糊,AI能救一半
视频帧的块状噪点先跑AI降噪,再放大1.5到2倍,锐化量控制在30以内。放大超过2倍就开始编造细节。
视频帧天生带着压缩痕迹,暗部尤其惨,色块和噪点混在一起。我的顺序是先降噪后放大,反了的话噪点会被一起放大,锐化之后满屏渣感。降噪强度我压在中档,别贪干净——视频帧本来就该有点颗粒,全抹平了会有种塑料般的「高清」,反而假。
放大是救命的一步。平台封面常用尺寸比1080p帧还大,1.5到2倍的AI放大基本可用,脸部细节救得回来。但别贪,我试过把一张帧放大3倍,眼睛是清楚了,睫毛根根分明,问题是那些睫毛AI自己编的,本人的睫毛没这么密。放大到2倍为止,是我交过学费的线。
封面帧和内页截图,修法是两套
封面帧按海报修:表情第一、留白给标题、饱和度加10;内页截图按资料修:文字清晰优先,不折腾颜色。混着修两头不讨好。
封面帧的使命是让人停下滑动的手。修完画质之后,我会把人物表情调到位,画面一侧留出放标题的空位,饱和度加10左右,让缩略图那么小的尺寸下也能跳出来。封面的构图逻辑和短视频封面是相通的,之前写过一篇短视频封面 ai修图:三秒决定划不划走的活,那篇讲得更透。
内页截图是另一种生物。观众看它是为了信息,不是为了美感,所以文字清晰度优先于一切,颜色够用就行。我把对比度轻提一点、边缘锐化一小下就收手,杂乱背景用AI压暗或虚化,让文字区凸显。别把内页截图修出封面感,信息图就该有信息图的样子。
留白的位置我吃过亏:早期做封面把人放在正中间,标题只能压在脸上,缩略图里字和脸糊成一团。后来固定成人物占画面三分之二、留出一侧放标题、标题不超过九个字。改完之后同样的视频,封面换个构图,点击就换了个量级,两条命。
三平台尺寸,一次出齐
16:9、9:16、1:1三个尺寸一次做完,横图改竖图用AI扩图补边,其余靠裁切。扩图只补背景,别让它碰主体。
横版封面发到竖版平台,直接裁会把人物裁出画面。我的做法是先裁切找构图,实在不够放才用AI扩图,扩的方向永远只有背景。扩图补出来的背景偶尔会有涂抹感,所以能裁切解决的不扩图。三个尺寸做完,一条视频的图就齐了,从抽帧到全套出图25分钟,比早期我干三个小时的第一版,快了七倍不止。
这套流程跑熟之后,做视频封面对我来说不再是碰运气的事:帧从哪来、糊了怎么办、三个尺寸怎么出,每一步都有固定的下一步。修图AI视频素材这件事,难的不是任何单一技巧,是把它变成一条不用现想的流水线。流水线立住了,你才有力气去琢磨封面文案那些真正花心思的事。
常见问题
直接用AI生成一张封面图不行吗?
行是行,但观众是认脸来的。真人频道的封面换了生成图,点开发现不是视频里那个人,信任感直接掉。生成图适合纯图文账号,真人出镜的还是自己的帧。
每一段视频都要修帧吗?
不用,只修封面和关键卡点要用的几张。我一条视频最多修五六张图,全是封面和节点位,正片里的图一张不修。
抽出来的人脸是畸变的怎么救?
广角镜头拍的帧,脸部边缘容易拉宽,先用AI矫正透视再做后面的步骤,顺序不能反,反了修完再矫正又会糊回去。
用别人的视频抽帧修图有问题吗?
自己的视频随便修,别人的帧拿来做封面就是素材侵权,和截图搬运一个性质。要引用别人内容的画面,先拿授权。