ai模特人工智能原理科普:一张图怎么画出来,手指和衣服为什么会错
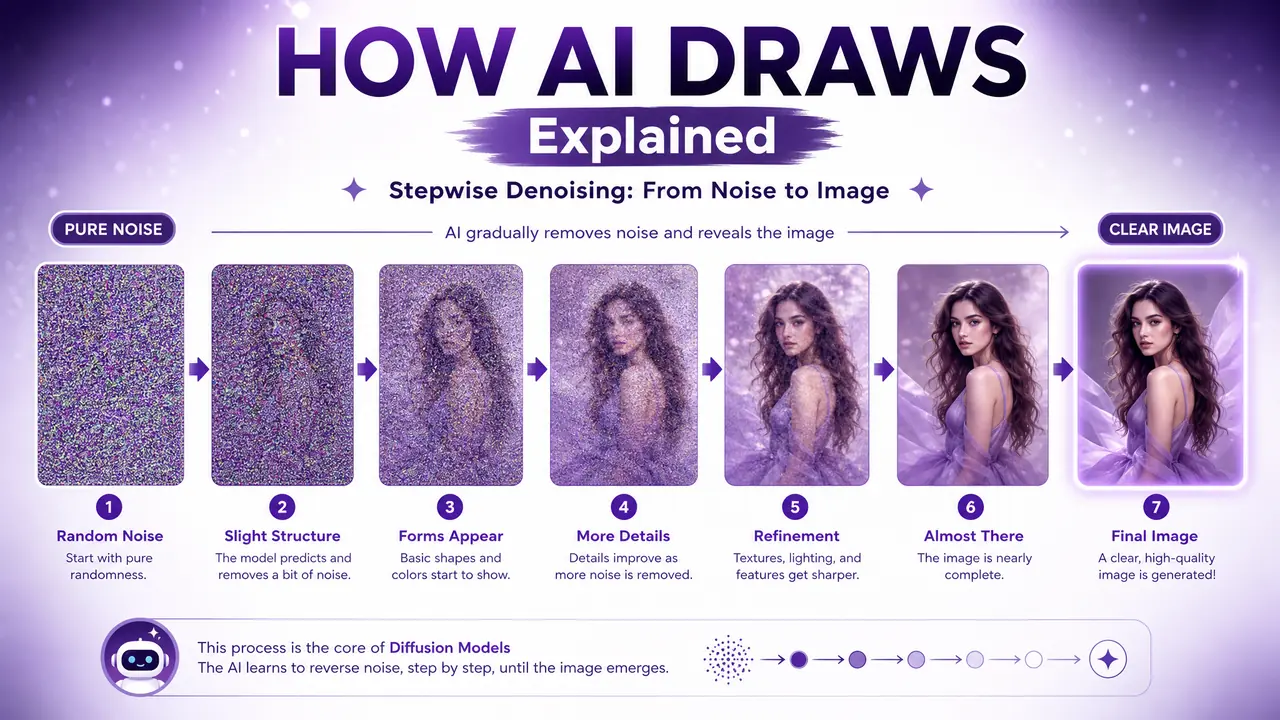
大白话版本:AI模特的底层是扩散模型,一步步从噪点里"擦"出一张人像图。手指画错、衣服走样不是Bug,是这套机制的天然副作用。可控性靠参考图约束,能管住大方向,管不住每一根线。看完这篇你就知道哪些坑能绕、哪些只能靠后期。
AI模特图这两年在电商圈铺开,很多卖家心里其实悬着一件事:它到底是"存了个真人照片再拼一下",还是真的在"画"一个人?这个问题不搞清楚,后面的用法全是蒙的。我的答案是后者——模型里没有任何一张真人照片,它学的是几十亿张图共同呈现的统计规律,出图是在凭规律"想象"。
先自我介绍一句:我给几家电商公司做过AI出图内训,从零基础运营到修图师都带过。手痒的运营最爱问的不是怎么写提示词,而是"它为什么会画出六根手指""衣服为什么自己换了款"。这篇就顺着这些疑问,把原理用大白话讲一遍。想先看落地操作的朋友,可以对照这篇AI模特生成操作教程,两篇一起看更顺。
AI是怎么"画"出一个人的
扩散模型的原理一句话:把真实图片逐步加噪点捣成雪花,训练AI学会反向把噪点一步步还原成图,AI模特出图就是从一张纯噪点开始"擦"出来。
展开讲。训练时,系统拿一张真实模特照,加一点噪点,再加一点,加到几十步之后整张图变成雪花屏。这个过程的每一步都被记录下来,喂给模型去学:"这一步长这样,下一步该往哪擦。"学了几十亿张图之后,模型脑子里装的不是"某个人",而是"人长什么样""衬衫下摆怎么垂""光线从左边来阴影往哪边落"这类概率规律。
你点"生成"那一刻,它拿到的是一张纯噪点图,然后按你写的提示词当导航,一步步把噪点擦掉。这个过程像什么?像修复一幅被水泡花的旧画——画里本来就有一个轮廓,修复师凭经验和常识把它补完整。AI模特补的每一笔,都是它"见过"的图里最可能出现的那一种,不是从库里复制粘贴的。
明白了这一点,很多疑问就顺了。为什么同一句提示词出两张不一样的图?因为起点噪点是随机的,修复路线不一样,终点自然不同。为什么它画得出训练集里没有的姿势?因为规律可以组合,人×光×布料×姿势,自由排列。这也回答了卖家最关心的那个:AI模特图是不是真人照片?不是,是概率拼出来的"没见过的人",跟某个真人对不上号——但这句答案有边界,后面细说。
手指为什么老出错:手是全图概率最不"稳"的地方
手指容易错,是因为手指小、姿态千变万化、还经常被遮挡,模型学到的规律最模糊;它画的是"大概有五根"的统计印象,凑数时就会四根六根并在一起。
讲透一点。脸为什么基本不出错?因为脸在训练图里几乎永远是正面、居中、完整露出的,规律清晰得像考试重点。手就没这个待遇——今天插兜、明天扶眼镜、后天被袖子遮掉半截、后面还可能捏着个杯子。模型学到的手,更像一团"五根左右、关节会弯"的模糊印象,落笔时就得现场"编"。
我再补一个内训时观察到的现象:手指错得最狠的,多半是扶、捏、拎这类动作图。五根手指互相挨着,在这个像素尺度下挨得太近了,模型在"分家"时经常把两根黏成一根,或者凭空多补一根。人脸占据的画面比例大、样本又规整;手占的像素少、姿态样本又散,此消彼长。
实招有两条。一是换动作提示词,把"扶着包"改成"手自然下垂",难度直接降一档;二是出几张里挑一张手正常的,按我的经验,脸和衣服都稳的图,抽十张能有三四张手也没毛病——剩下的靠局部重绘补,别指望每张都过关。
衣服为什么会变样:纹理是"印象"不是"存档"
衣服变样是因为模型只记住了品类与材质的统计规律,没有保存你家那件的具体版型;两次生成各自"想象"了一遍,印花位置、纽扣间距、褶皱走向就对不上了。
我自己内训时被问得最多的就是这条。卖家的期待是"同款同款",模型给的却是"很像的一类"。它记住的是"碎花连衣裙一般长这样""雪纺会有这种垂坠感"这种规律,不是你家这件的三围档案。
生活化一点的比喻:你让一个没见过你家的人"凭记忆把你家客厅画出来"。沙发、茶几、窗帘他都能画出个大概,风格也对,但靠墙那个斗柜他画成了三个抽屉——你家里其实是四个。他没撒谎,他只是在"想象"。
所以细分起来,变样的容易程度是有档次的:版型(长裙还是短裙)最好管,一句话就能锁住;材质(真丝的垂坠感)次之,多写几个词能逼近;最飘的是细节数量——纽扣几颗、印花具体什么图案,这种"数数"和"精确复现"的活儿,恰好是扩散模型的弱项。商家脑标、logo这类要在正文细节里印准的元素,直接出图基本没戏,得靠后期合成或者局部重绘去贴。
| 现象 | 背后的技术原因 | 现实对策 |
|---|---|---|
| 手指四根或六根 | 手部样本姿态杂、像素占比小,统计规律最模糊 | 改动作提示词;抽卡挑选;局部重绘修手 |
| 印花挪位、图案变形 | 模型存的是"印象",不保存具体图案坐标 | 生成后用贴图工具合成,或局部重绘 |
| 同提示词两次结果不一样 | 起始噪点随机,去噪路径不同 | 固定种子参数可复现,但要接受构图会变 |
| 面料质感不够真 | 材质靠文字描述间接引导,精度有限 | 喂参考图加权,别只靠提示词硬写 |
那衣服这块到底能管到什么程度?这就得说可控性的实现方式了。主流做法是参考图约束:垫一张图让AI照着构图、姿势或版型去画,原理相当于给修复师递了一张草稿——"别自由发挥,照这个骨架补"。约束力分三档,从松到紧是风格参考(只管氛围色调)、姿势参考(骨架对齐锁动作)、版型参考(锁衣服轮廓)。给哪一档,模型就守哪一档的约,越紧的档位牺牲的自由度越多,出图也越容易僵。
这里要把话说实:参考图能锁住"这一版是A字裙、袖口这个宽度",锁不住"胸前第四颗纽扣的线头走向"。指望垫一张图就百分百还原服装细节,目前做不到,谁跟你保证谁在吹。电商公司实际的工作流都是"AI出大图+人工修细节"两条腿,我见过的跑通了的团队没有一家是纯AI直出的。
工具层面多说一句。SD生态的ControlNet是这套约束玩得最细的,姿势和版型能精确控制,代价是学习曲线陡——我在内训里带过十几个人上手,最后坚持用下来的大概三成。多数电商团队最后选了更轻的路线,先出图再挑再修,整体效率反而更高,SD跑AI模特图的完整流程里记了具体走法。还有同一个人脸跨图保持一致的进阶玩法,适合做系列款,坑较深,这篇不展开。
接下来会往哪走:一线的几个观察
趋势是稳定性补课和精准控制:手指合格率在一代代模型里明显爬坡,服装细节还原靠"参考图加局部重绘"组合拳,纯提示词路线会越来越边缘。
我自己的手感:两三年前六根手指几乎篇篇中招,现在的旗舰模型十张里能对八九张,进步是真金白银的。方向也清楚——模型厂家在加"手部专项"的训练权重,数值类问题(纽扣数、条纹数)也在被专门针对,因为这是商用落地的最大堵点。
第二个观察,视频化。静态图跑通之后,同行都在试模特转身、面料飘动的视频素材。离"可商用"还差一段:逐帧抖动、手部崩坏在视频里更容易暴露,一段三十秒里挑两三秒能用的片段,是现在的常态。
说句实在的个人判断(可能不讨喜):AI模特不会替代真人拍摄,会把它挤到头部品牌。走量、上新快、预算紧的店铺,AI出图是划算的;高客单、讲品牌调性的,棚拍的地位动不了。工具吃掉的是中间那块"以前请不起棚拍"的市场。
回到开头那个问题:AI模特不是存图拼接,是真的在"画",靠学来的统计规律一步步把噪点擦成人像。理解了这一点,手指错、衣服飘就不再是玄学——那是"凭印象想象"这件事与生俱来的代价。你能做的是顺着它的脾气来:管大方向靠参考图,抠细节靠后期,抽卡要有耐心。把期待值校准到这个位置,AI模特图才真正开始帮你省钱。
常见问题
AI模特图用的是真人的照片吗?
不是。扩散模型没有存储任何一张真人照片,它学的是海量图片的统计规律,出图是"想象"出来的、训练集里不存在的人。要留意的是,如果你垫了某位真人的照片当参考,产出就可能带着那个人的长相特征,商用前最好确认肖像授权,别拿别人头像垫图。
为什么AI模特图每次生成结果都不一样?
因为每次生成的起点是一张随机噪点图,去噪路径不同,终点就不同。想复现就固定随机种子参数,但换了提示词或模型版本,一样会变。电商批量出图一般靠"多生成几张挑最好的"来兜底,别指望抽卡变成确定性生产。
AI模特的手指问题现在解决了吗?
大幅改善,没根治。2026年的主流模型十张里大约七八张手是正常的,扶、捏、拎这类精细动作还是容易翻车。实用做法是挑出手正常的图,剩下的用局部重绘单独修手,全靠模型自己长进还不够。
衣服细节(logo、印花)能被AI精准还原吗?
不能,至少目前不能。模型对"数数"和"精确复现图案"这类任务天然不擅长,印花会挪位、logo会变形。通用做法是AI出底图,后期把logo和印花当贴图合成上去,工厂详情页那条线尤其要这么干。
不会写代码的卖家能用好AI模特工具吗?
能。现在主流工具都是网页操作,打字选图就行,学习成本比Excel高不了太多。真正要花时间的是理解这套工具的边界——知道哪些它做得了、哪些别勉强,比学会几十条提示词技巧有用得多。