ai盲人绘画能走通吗:语音描述出图、听画与一晚陪试的实录
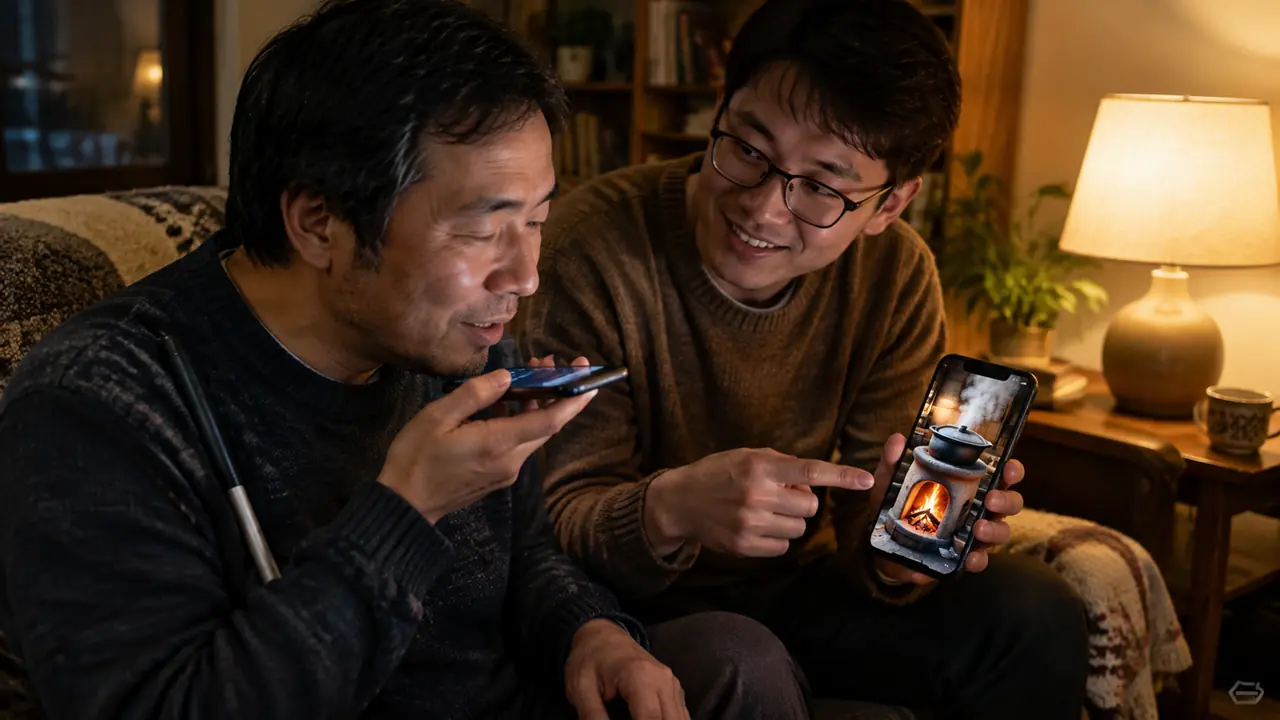
我的判断是:ai盲人绘画值得认真对待,它的正确形态是"语音进、图出、耳朵收",视障者出想法和判断,AI出手艺,明眼人当翻译。不是替盲人画画,而是把画笔换成一嗓子。这是我陪朋友实测一晚得出的结论,别急着认同或反驳,先看过程。你要做的第一件事,是找一位愿意试的朋友,从描述一个他最熟的地方开始。
ai盲人绘画这个说法,我以前刷到都是当猎奇新闻划过去的。转变发生在上个月:认识多年的老周,三十岁出头因为意外全盲,某次饭局上他问我,你们天天发那些图,能不能也让我"画一张"。我答应回去研究,认真查了一圈才发现,这条路比想象中现实——语音输入早就是成熟功能,缺的是没人带着走一遍流程。
于是有了那个晚上。这篇是那晚的完整记录,加上我事后的一些思考。先说清楚立场:我们不谈"治愈"不谈"奇迹",就聊技术流程和真实体验,能到哪一步就是哪一步。
看不见的人,怎么"下笔"?
视障用户画AI图的实际路径:语音口述画面细节,AI出图,陪同的人把结果念回去,根据反馈改词再出。整条链路里视障者做导演,AI做画手,描述的颗粒度决定了成图的上限。老周上手比我预想的快得多,十来分钟就摸到了门道。
那晚的第一张图,老周口述的是他外婆家的灶台:"土灶,铁锅,柴火在灶膛里,墙上挂着一串蒜。"出图十几秒,我念给他听:画面有灶有锅,但是柴火变成了一捆整齐摆放在灶边的柴,火没烧起来。他立刻说不对,"灶膛里的火要看得见,锅上要有汽"。改词,重出,第二次火有了但还是偏大,他说"外婆烧火没那么猛,火要小一点,锅边要坐人"。第三次出图,我还没开口念,他听我念到"锅边坐着个模糊的背影",就说:这张留着。
这个过程给我最大的震动是导航方式。我们明眼人出图靠"看一眼改一句",他靠的是记忆里的画面在比对——灶台的温度、柴火的响声、蒜串的位置,全是他的校对工具。第三稿的判断用时不超过五秒,比很多明眼人抠细节还果断。
操作层面有个必须交代的技术点:语音转文字对描述类长句的识别很好,但"灶膛""土灶"这类生活词偶尔转错,出来图会莫名其妙。我们的办法是我把转写结果念还给他确认一遍再发送,多一步,省很多废图。
反过来的需求:AI能替他"看"一张画吗?
能,而且这可能是更刚需的方向:把图喂给能识图的语言模型,让它按"从整体到局部、从左到右"的固定顺序念出来,视障者就能听懂一张画的构图。但要守一条边界——念的是描述,不是体验,颜色这种词他听懂了也不等于看见了。那晚我们把两个方向都试了。
试的过程有个细节,我到现在还会想起来。我把一张海边日落的图让模型描述,它说了构图说了色调,老周听完问了一句:"太阳在海平面上下沉,那光在水面上的那条路,是晃的吗?"模型答不出来,我更答不出来。这一下让我明白,听画能补信息,补不了体感,两边永远隔着一层。老周自己的说法豁达得多:他说他本来也不是要"看见",是要参与——别人聊图的时候,他能接上话,这就够了。
实操上我总结了个念图模板:先一句整体(什么场景、什么时间),再从主到次说三个物件,最后说光和氛围,总共三四句话封顶。念太长,听觉记忆抓不住重点。顺序每次保持一致,听的人脑子里能自己搭出一张"地图",第二张图就省力多了。
还有一层体验是明眼人容易忽略的:念图时的语气和停顿,本身就是画面的一部分。同样一句"灶膛里的火很小",念得平或者念得暖,听感完全两样。给家里人念图的时候,别把它当成读说明书。
想陪家人试,从哪个场景入手?
从对方记忆最深的场景入手,别从"你想要什么图"入手。记忆场景自带全部细节,描述不愁没话说,改词也有依据;凭空想画面,视障者反而容易卡住。我们那晚四张成图,三张是回忆场景。这个顺序是试错试出来的。
老周那晚的四张图:外婆的灶台、老屋门前的晒谷场、他失明前最后一次爬的山、还有一张他自己的想象——"有没有可能画一种不存在的鸟"。前三张他越改越有劲,第四张卡住了,他说"我想不出来,脑子里的素材全是看过的东西"。这句话我琢磨了很久,所谓想象不是无中生有,是旧素材的重组,对失明多年的人来说,重组的原料库和我们不一样而已。
给你列一个适合入门的回忆场景清单:老家的灶台或饭桌、小时候的院子、常走的一条街、某个人的背影。这些场景的共同点是有触觉、嗅觉、听觉的锚点,描述得出来,也校对得回来。出图之后的展示别搞花活,把图打印出来给他摸画框的位置、听你念描述,这套闭环比发社交平台实在。
另外提醒一句分寸:陪视障朋友玩这个,节奏让对方定。那晚老周玩到第三张就主动喊停,说耳朵累了。语音交互的疲劳来得比视觉快,一次三四十分钟刚好,贪多反而把兴致磨没了。想再深一步了解怎么把回忆画成画面,可以看照相ai绘画怎么画出老照相馆的味儿:蝴蝶光、民国布景与全家福站位那篇,老照片式场景的记忆锚点特别密,很适合这类口述出图。
那晚结束的时候老周说了句让我没接上话的话:他说这是他失明以后第一次"改"一幅画,以前画是别人的事。ai盲人绘画这条路的尽头在哪我不知道,但起点已经很清楚了——不是技术不够,是没人陪第一批用户走第一遍流程。你要是身边有这样的朋友,那晚的做法可以直接搬走,从一张灶台开始。
常见问题
视障者完全看不见成图,那画出来算谁的作品?
我的看法是算口述者的。构图、内容、取舍全是他的判断,AI只是执行了手的部分,这跟摄影助理按导演要求布光是一个道理。当然最终怎么署名,尊重创作者本人的意愿就好,老周自己倒是不纠结这个,他更在意那张灶台画得对不对。
现在有能直接"摸"的立体图吗,这个流程能转成实物吗?
有相关技术在探索,比如把图像转成可触摸的浮雕线条,但我没实测过效果,不敢下结论。我们家那晚的闭环是念图加触觉参照(让他摸了画框和打印纸的边界),实物转化这条路值得等它成熟一点再评估。
语音转文字老出错,有没有省事的替代办法?
让转写结果先过一遍人耳:陪同的人把识别出的文字念回去确认,改完再发送。多十几秒,但能拦下大部分因错别字跑偏的废图。等对方用熟了,常见词的误转规律也摸清了,这步可以慢慢省。
这事会不会其实是我们明眼人的一厢情愿?
问得很对,所以节奏一定要对方说了算。老周是主动提需求的,那晚他玩得投入但也叫了停。我的原则是搭好台子、随叫随到,不推销不感动自己,兴趣这件事替别人做不了主。