AI绘画加AI视频:静图动起来的成本和坑,我都替你试了
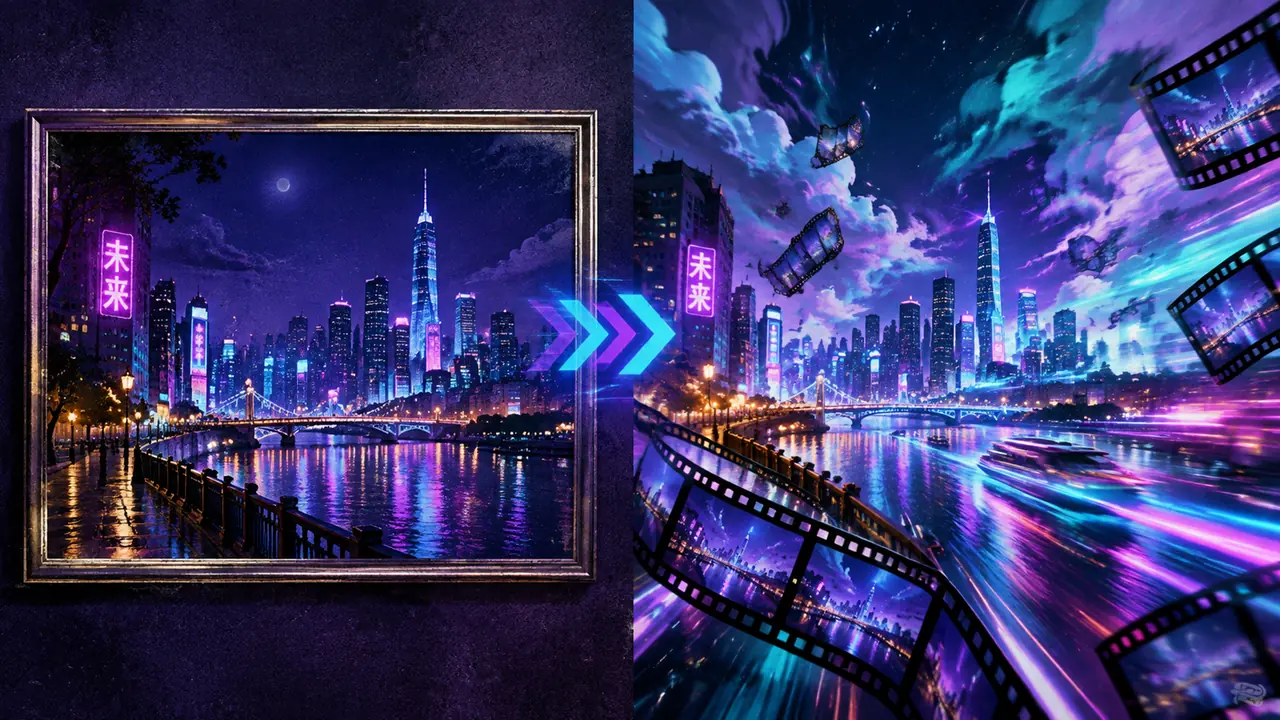
直接给结果:AI绘画加AI视频,先把静图磨到八十分再动,成功率翻倍;反过来先动再补图,几乎条条返工。我拿同一张夜景图在三款工具里各动了一轮,二十一条片段只成活七条,账目和坑位全在下面。
一直有人问我,AI绘画加AI视频这条流水线到底怎么搭。我的答案先写在前面:图是地基,视频是楼上,地基歪了楼必塌。这话是我拿一个周末、二十一条废片换来的。
起因是我给自己的公众号做一张会动的封面——城市夜景,霓虹灯微微闪,车流拖出光轨。想法很简单,落地花了我整整两天。下面把这两天的过程拆开,谁想走这条路,能少摔几个跟头。
先出图还是先写脚本
先出图。图定了构图、光源和运动主体,视频工具只负责让它们动;跳过出图直接想镜头,等于没打地基先砌墙。这是我二十一条废片换来的第一条经验。
第一天我犯的错就是顺序反了。上来就琢磨"镜头从左往右推,霓虹灯闪烁",结果发现视频工具吃的是我给的那张静图,静图里车是歪的、楼是斜的,动起来只会把歪斜放大三倍。二十一条片段里,前十一条全是从没打好的底图上长出来的废片。
回头重做出图。这次的静图我特意按"要动"的标准来挑:留了三分之一的天空给云做位移,车流放在画面下沿不抢主体,霓虹灯牌单独一块、边界清楚。同一句提示词我出了十二张,挑图标准只有一条——闭上眼能想象出它动起来的样子,才配进视频环节。十二张里有一张云压得太满,天空连动的余地都没留,只能毙掉。
挑出来的那张图,第一段生成的片子就直接能用了。前十一条废片和后十条里成活六条,差距全在出发那一步。
画面动起来之后,坑都藏在哪?
图生视频的坑集中在三处:人脸和手崩、画面鬼影、运镜提示与实际运动对不上。无人物的风景图能躲开大半,有人就得多备三倍额度。
第一个坑是鬼影。我的夜景里有一块巨型LED屏,视频工具自作主张让屏上滚动播放"内容",播出来的字全是抖动的乱码条纹,远看像信号故障。第二版我把屏写进提示词要求"静态不变化",鬼影消失了——所以图里凡是文字和屏幕,要么提前想好怎么动,要么明令禁止动。
第二个坑是运镜漂移。让镜头"缓慢右移",移到第四秒画面开始往上飘,楼的透视整个歪掉。三款工具里有两款都有这毛病,后来我学乖了:运镜幅度词全部往小了写,"缓慢""轻微""几乎不动",宁可镜头死板,不要镜头乱跑。
第三个坑我替你们踩过了:别轻易让人出镜。顺手试了加一个站在天桥上的人影,十秒片里他的背影先是多了一条腿,然后融化进栏杆里。二十一条里所有带人的片段,全军覆没。风景、静物、光影先练熟,人物是后期课题。
一条十秒动图的真实账目
成片一条十秒动图,背后是出图十二张加视频生成二十一次,总耗时约四小时,消耗的积分够普通人日常两天量。按这个损耗率倒推预算,心里就有数了。
细账给你摆出来:静图十二张,两个平台各跑一遍挑最好的,约四十分钟;视频二十一次,单次生成一到三分钟,排队另算,纯等待就一个半小时,期间我练出了边排队边修下一张图的多线程本事;剩下时间全在挑片和微调动效词。最后成片是第七条——霓虹灯闪三下,云飘了半屏,车流光轨慢慢拖过去,循环播放看不出接缝。
- 选一张能"动"的静图,留出运动空间,剔除文字元素
- 动效词一次只写一处,幅度词往轻里写
- 先出三秒短片测试,稳了再上十秒
- 带人的画面最后再碰,或者干脆不碰
成本上我最意外的发现是:积分烧得最快的不是生成,是重试。每次失败一条就烧一次,二十一条里十四次重试占了七成消耗。所以省钱的唯一办法是把图做好——图省事,钱遭罪。
两天折腾完,那条十秒的夜景动图挂上了公众号封面。有读者留言问"你这封面会动,用的什么模板",我回:没有模板,是十二张图和二十一条废片。工具把门槛从"不会拍"降到了"肯折腾",但没降到零——这条路上省下的每一分钟,最后都变成了重试的积分账单。
常见问题
图生视频和直接文生视频哪个更好?
想要画面可控就用图生视频,构图、色调都锁死在你的静图上;文生视频自由度高但抽卡更狠。做封面、片头这类有明确预期的活,图生视频稳得多。
十秒的片子为什么经常生成不满时长?
常见原因是结尾元素的运动提示冲突,工具提前收尾。把最后两秒写成"画面保持缓慢"之类的弱运动词,满时长的比例会明显提高。
动态封面用什么比例合适?
公众号头图和大多数平台封面用十六比九,竖屏信息流用九比十六。做之前先确认展示位的裁切规则,不然动得再好看也被裁掉一半。
循环播放的接缝怎么处理?
让首尾帧的画面状态尽量一致:云的位置、灯光的明暗都用"回到初始状态"这类描述去约束。我那条片子是云飘半屏再飘回来实现的闭合,接缝基本看不出来。