ai绘画不笨,笨的是喂法:手崩、词不达意的三个根治写法
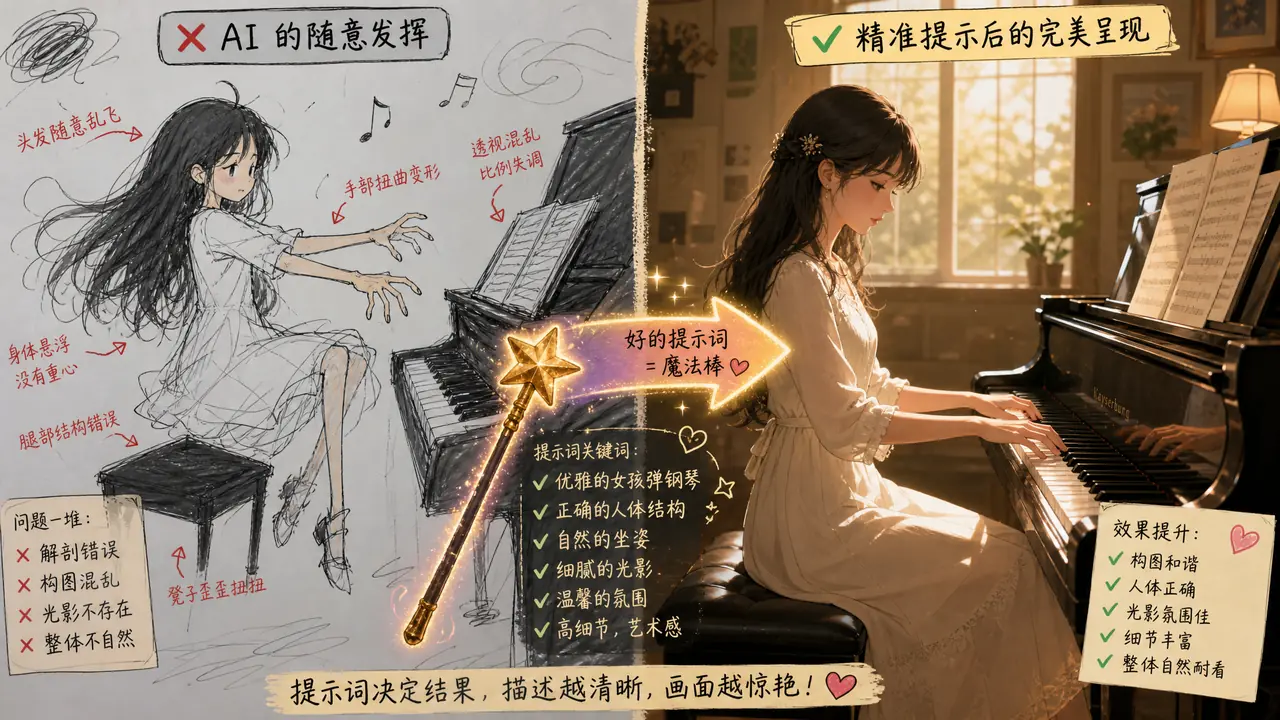
直说了:模型不笨,笨的是喂法。出图手崩、动作呆、听不懂人话,九成是提示词太抽象加流程太粗糙,改写法比换工具管用。我拿二十张实测把手部崩坏率从一多半压到两成以内,三步改法如下,照做就行。
ai绘画不笨这件事,我是被一张六指的图气明白的。那阵子我天天骂模型蠢,直到有位画手朋友看了我的提示词,笑出声:你写的"一个女孩在弹钢琴",模型上哪儿知道你要几根手指、什么手型、坐姿什么样?结论先放这:AI出图的笨,大部分是信息不足造成的瞎猜,把话说具体、把控制用起来、把错误修对地方,它立刻就灵。
这套判断我用三个多月、几千张图反复验过,下面拆开讲。
它为什么老画出一副笨样?
根子在训练与理解方式:模型靠词对图学概率,不是靠逻辑懂动作。提示词越抽象,它瞎猜空间越大,崩得越离谱。你给的信息密度,直接决定它出图的下限。所以别急着骂模型,先检查自己那行字。
举个我自己的对照。"一个女孩在弹钢琴"这句,我跑了十张,六张手型有问题,两张琴键画反,人物坐姿像悬浮。改成"侧身坐在琴凳上的女孩,双手平放琴键,指尖按下黑白键,手腕自然下垂,上半身微倾",同参数再跑十张,手型过关的变成八张,琴键没再反过。同一颗模型,喂法不同,判若两模型。
抽象词是大坑。"优雅地 dancing""开心地笑"这类词,模型只能从训练数据里捞最常见——也是最俗的对应画面。想跳出俗套,就得用画面语言写:动作拆成身体部位,情绪换成表情细节和肢体语言。
三个改法,让出图立刻灵起来
改法就三步:动作写到位(拆身体部位)、用控制工具钉住姿态(姿势骨架或参考图)、崩了别整张重抽,用局部重绘只修错处。三步走完,废片率能砍掉一大半。每一步我都有翻车教训,挨个说。
第一步,动作拆解。别写"跑起来",写"双臂前后摆动,左腿蹬地右腿迈出,马尾甩向身后"。模型对部位级描述的还原率明显更高,这是我用同一场景跑双批次比出来的。
第二步,控制工具。姿势不对就上骨架控制,把人体姿态钉死再抽卡。我之前嫌麻烦不肯用,一晚上为了一个抱琴姿势抽了六十多张全是歪的,回头用骨架十分钟解决,肠子都悔青了。这类逐步控制的思路,跟ai绘画东南方位控光实测:提示词里写方向,晨光真的会听话里光位控制的逻辑是相通的——能锁的变量全都提前锁死。
第三步,局部重绘。整张重抽等于把好运气也一起扔了。我的流程是:出图后只圈崩的地方(多数时候是手),降低重绘幅度到三到四成,重跑一到三次。上个月修手二十张,一次修好的十一张,两次修好的六张,只有三张救不回来直接废。
- 手部:圈手+重绘幅度35%左右,保留周围衣袖衔接。
- 脸部:崩脸优先修眼睛,幅度压到30%以下,不然换脸。
- 物件穿模:扩大选区把交接处包进去,只圈穿模点会反复穿。
什么时候该认输换思路?
同一句提示词连抽十五到二十张还是同一种崩法,就不是运气问题了,是这句词本身把模型带沟里了。这时候该改词或换构图,不是继续赌。我给自己定的止损线就是二十张,到线必停。
上个月画一个持伞回眸的动作,二十张里伞柄全是断的,我倔着又抽了十张,还是断。最后把"手持长柄伞"改成"伞倚在肩上,手扶伞身",第一轮就出了三张能用的。模型的先验改不动,你只能顺着它的知识改自己的词。这个止损习惯救了我大量积分,也比闷头重抽更有尊严。
说到底,ai绘画不笨的前提是你先当个明白人:把话说明白、把姿钉死、把错修准。这三件事任何一件偷懒,废片率都会原样涨回去。工具在进化,但"会喂"这件事短期内还轮不到模型替你做。
绕回开头的结论:模型不笨,笨的是喂法。抽象词换画面语言、姿态上骨架、崩处局部修,三步做完你就很难再见到六指钢琴家了。我现在的习惯是写完提示词先自问一句——这句话里有没有任何一个词是模型能"自由发挥"的?有就删掉重写。你要是也总抽出一副笨样的图,先把今晚那批废片翻出来,对照三个改法逐条找原因,多半一找一个准。
常见问题
换一个更新的模型是不是就不笨了?
新模型确实手脚更好,但抽象提示词的问题它照样有。喂法不改,换模型只是把崩法换个花样,钱花了毛病还在。
局部重绘会不会把周围弄花?
重绘幅度别拉太高,三到四成是安全区,选区边缘记得多包一点过渡区域。我头几次翻车都是幅度拉到七成,修完手周围一圈马赛克。
动作写得特别细,模型会不会不听?
会偶尔不听,这正常。细描述的意义是提高命中概率,不是百分百保证。十张里能中七八张,就比抽象词强太多了。
骨架控制上手难吗?
不难,画几个圆圈连线的事,十分钟就能学会基本摆姿。嫌麻烦可以直接拿自己摆拍的照片提取骨架,比手摆还快。